
Existe um arquivo no seu site que muita gente publicou achando que estava resolvendo duas coisas ao mesmo tempo: apresentar o conteúdo para as IAs e controlar quem pode rastreá-lo. A segunda parte nunca foi verdade, e agora existe um levantamento em escala mostrando o tamanho da confusão.
A Common Crawl analisou 584.107 arquivos llms.txt coletados na própria base e publicou o que encontrou dentro deles. O resultado é desconfortável: 68% vieram de plugin ou template, 22,56% não têm nenhum link e uma fatia dos arquivos tenta impor regras de rastreamento que o formato simplesmente não tem poder de aplicar.
Se você faz GEO, esse é o tipo de dado que evita desperdício de tempo. Vamos ao que o estudo mostra, ao que ele não mostra e ao que fazer com o arquivo que já está publicado no seu domínio.
O que a Common Crawl mediu
A análise foi divulgada pelo engenheiro de pesquisa sênior Malte Ostendorff e detalhada pelo Search Engine Journal. A amostra veio de sites que o CCBot, o rastreador da Common Crawl, tinha buscado recentemente sem problema. A partir daí, o time solicitou o arquivo /llms.txt em um conjunto amplo e aleatório desses sites, amostrou /llms-full.txt de forma mais específica e incluiu domínios já conhecidos por servir um dos dois arquivos.
Isso importa para interpretar o número de adoção. A taxa de 11% para /llms.txt citada no relatório vale dentro do universo de sites acessíveis ao rastreador, não para a web inteira, e o próprio texto avisa que não é diretamente comparável com os números da Ahrefs ou do Web Almanac, porque as populações são diferentes.
A maioria dos arquivos é template, não curadoria
A proposta original do llms.txt é oferecer aos sistemas de IA uma lista curada das páginas que realmente importam no site. Curadoria é o ponto. E é exatamente o que falta na maior parte dos arquivos.
O Wix responde sozinho por 41% dos arquivos analisados. Entre 73 mil arquivos gerados pelo All in One SEO, o relatório aponta que nenhum escreve o resumo previsto pelo formato, com mediana de 138 links, ou seja, o plugin trata o llms.txt como um sitemap. Arquivos de domínios estacionados da GoDaddy passam em todos os testes estruturais mesmo sem links, funcionando como peça de venda.
| O que a Common Crawl encontrou | Proporção | Leitura prática |
|---|---|---|
| Arquivos originados de plugin ou template | 68% | O conteúdo reflete a ferramenta, não a estratégia do site |
| Arquivos com a estrutura completa testada (H1, resumo em citação e seções de links) | 49% | Metade não segue o formato como proposto |
| Arquivos sem nenhum link | 22,56% | Não cumprem a função de indicar páginas relevantes |
| Arquivos com diretrizes de uso do site pela IA, como limites de taxa e aviso de copyright | 6% | São regras que o padrão llms.txt não cobre |
| Arquivos robots.txt servidos no caminho do llms.txt | 136.578 casos, cerca de 10% das respostas HTTP 200 | Sinal direto de confusão entre os dois arquivos |
O erro central: llms.txt não é robots.txt
Esta é a parte que precisa ficar clara para qualquer time de SEO. O relatório descreve o formato de maneira direta.
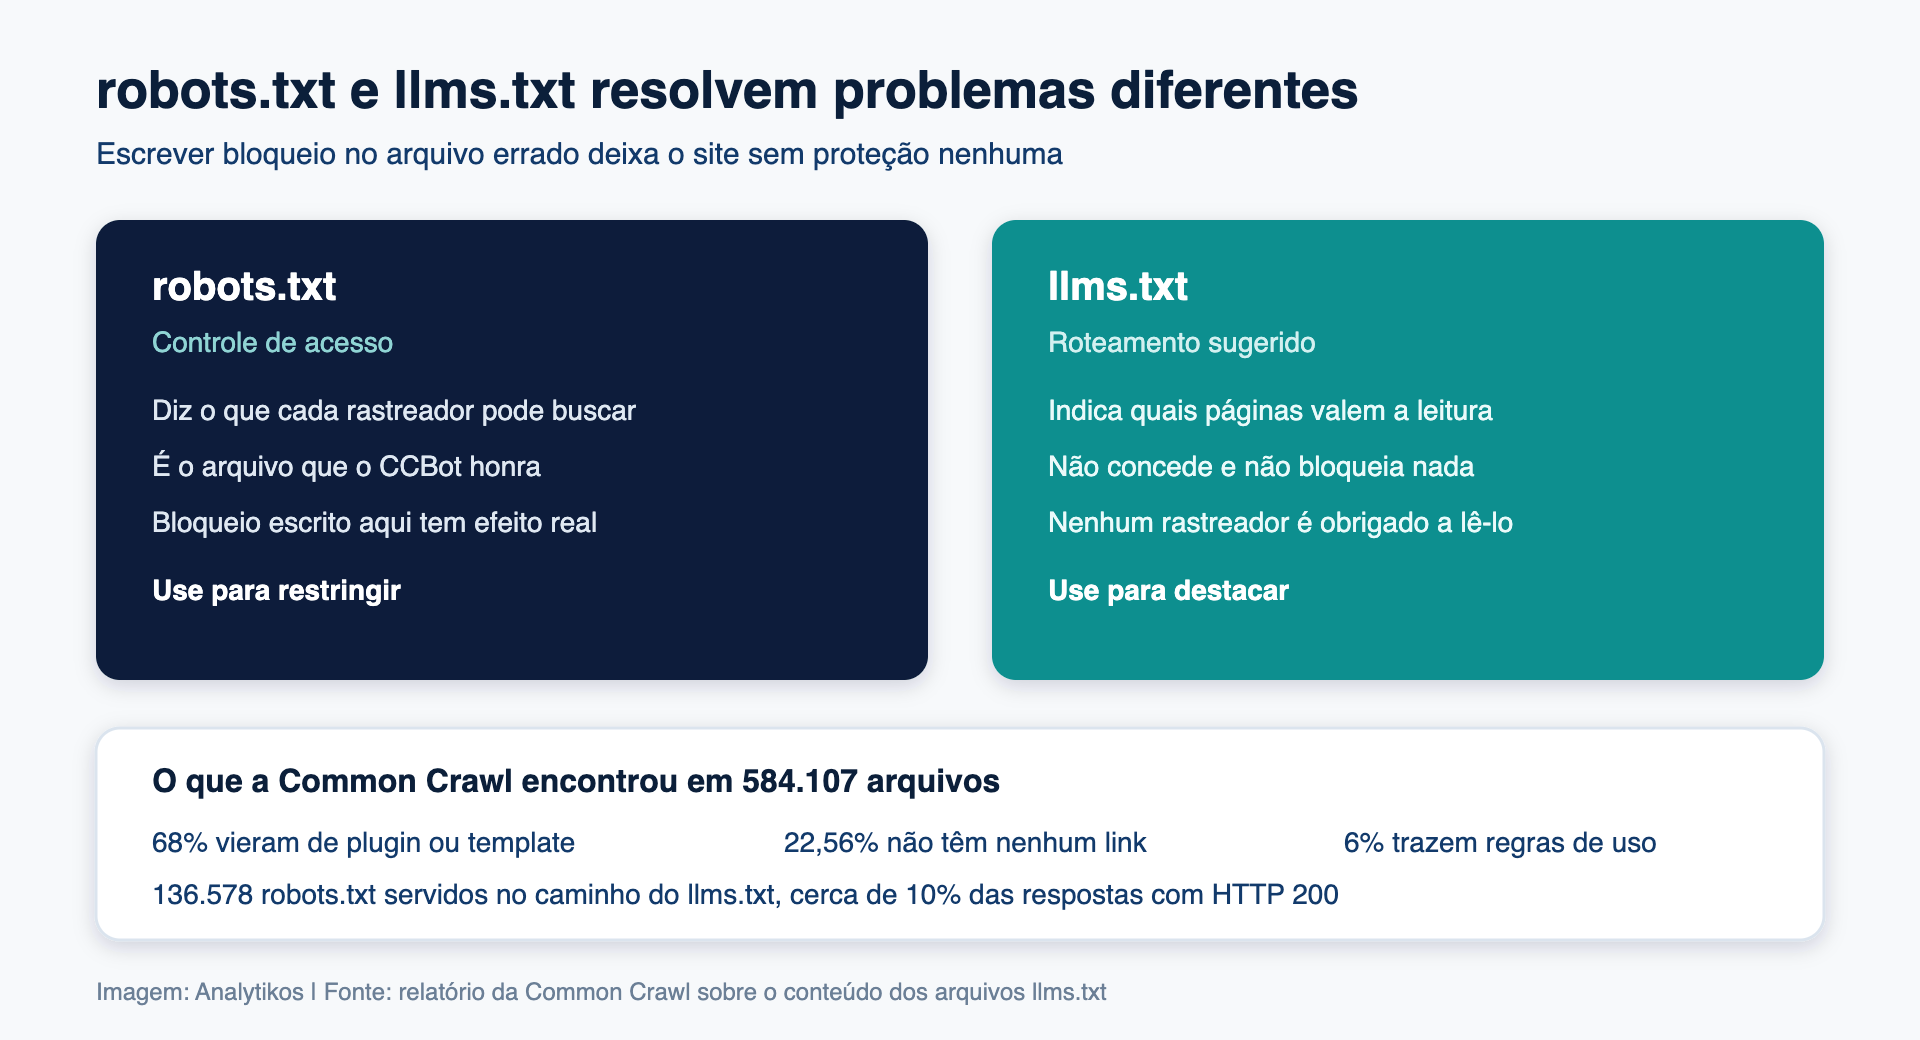
Ele não concede nada e não bloqueia nada, e nenhum rastreador é obrigado a lê-lo.
Relatório da Common Crawl sobre o conteúdo dos arquivos llms.txt
Mesmo assim, 1.570 arquivos citam um rastreador específico e 32 aparentam negar acesso ao CCBot. A Common Crawl foi checar o robots.txt desses 32 sites e conseguiu avaliar 31. Nenhum bloqueava o CCBot de fato: cinco permitiam explicitamente, onze restringiam alguns caminhos e liberavam outros, e quinze não tinham restrição nenhuma. Um site retornou erro HTTP 429 e não pôde ser testado.
O relatório cita um caso em que o llms.txt afirma que o CCBot está bloqueado desde junho de 2026, enquanto o robots.txt do mesmo site permite o rastreador por uma regra curinga. Em outras palavras, o arquivo virou uma descrição de política que saiu de sincronia com a política de verdade. Quem quer restringir rastreamento de IA precisa fazer isso onde funciona, assunto que já detalhamos no nosso guia para bloquear crawlers de IA.
Injeção de prompt existe, mas foi rara
O time aplicou um teste rigoroso para achar instruções dirigidas ao modelo e encontrou dez arquivos suspeitos, dos quais quatro eram casos reais, incluindo um cujo resumo manda o modelo ignorar instruções anteriores e buscar um segundo arquivo. Os outros seis eram falsos positivos, em geral documentação que citava tokens de controle para explicá-los.
Os autores fazem questão de dizer que a conclusão não é que o llms.txt esteja cheio de injeções. Nos casos reais identificados, as pessoas inseriram o texto de propósito, para provar um ponto. Além disso, 3.793 arquivos traziam orientações mais leves, do tipo pedir que o modelo priorize determinadas páginas.
O que o estudo não consegue provar
Vale a honestidade metodológica, porque ela muda a forma de usar o dado. A análise é de um único rastreamento, então não dá para dizer se templates, linguagem de política ou injeções estão aumentando. Ela também não confirma se algum sistema de IA lê esses arquivos. E as contagens de política e injeção vêm de correspondência de palavras-chave, o que o próprio relatório admite ser provavelmente uma subestimativa.
Sobre o uso real, o dado mais duro continua sendo o da Ahrefs, citado pelo Search Engine Journal: 97% dos arquivos llms.txt no conjunto analisado não receberam nenhuma requisição. Um estudo olha o conteúdo, o outro olha o acesso, e os dois apontam na mesma direção. É o mesmo tipo de ceticismo que aplicamos ao avaliar a eficácia da GEO à luz de 45 estudos.
O que fazer com o seu llms.txt hoje
Nada disso significa apagar o arquivo. Significa parar de esperar dele o que ele não entrega. Um roteiro curto e útil:
- Abra o seu /llms.txt agora. Se ele não tem links, ou se tem 138 links gerados automaticamente, ele não está fazendo curadoria de nada.
- Confira se há regra de bloqueio escrita ali. Se houver, replique a regra no robots.txt, que é o arquivo que os rastreadores honram, e mantenha os dois coerentes.
- Verifique se o servidor não está entregando o robots.txt no caminho do llms.txt. Foram 136.578 casos assim no levantamento.
- Cheque a estrutura mínima: um H1 e, de preferência, o resumo em citação. Nosso passo a passo sobre llms.txt sem links markdown falhando no Lighthouse cobre os erros de formatação mais comuns.
- Trate a prioridade com realismo. Antes do llms.txt vêm fundamentos que comprovadamente pesam, como orçamento de rastreamento e a lógica descrita no guia oficial do Google sobre AEO e GEO.
A atualização v2 do formato, que introduziu relações de link para facilitar encontrar versões markdown das páginas, não mudou o que o arquivo pode impor. E como plugins e construtores de site já produzem cerca de dois terços dos arquivos que a Common Crawl encontra, o futuro prático do llms.txt vai depender mais do que essas ferramentas geram do que de quem escreve à mão.
Perguntas frequentes
O llms.txt bloqueia rastreadores de IA?
Não. O relatório da Common Crawl afirma que o formato não concede nem bloqueia nada, e que nenhum rastreador é obrigado a lê-lo. Regras de acesso precisam estar no robots.txt, que é o arquivo que rastreadores como o CCBot honram.
Vale a pena manter um arquivo llms.txt no site?
Vale se ele realmente fizer curadoria: um H1, um resumo e uma lista enxuta das páginas que você quer destacar. Um arquivo vazio ou gerado automaticamente com centenas de links não cumpre a função proposta pelo formato.
Quantos arquivos llms.txt são de fato acessados por IAs?
Dados da Ahrefs citados pelo Search Engine Journal indicam que 97% dos arquivos no conjunto analisado não receberam nenhuma requisição. O estudo da Common Crawl analisou o conteúdo dos arquivos e não confirma se algum sistema de IA os lê.
Qual a diferença entre llms.txt e robots.txt?
O robots.txt é um arquivo de controle de acesso: diz o que cada rastreador pode buscar. O llms.txt é uma proposta de roteamento: sugere quais páginas valem a leitura entre as que já são permitidas. Um restringe, o outro apenas indica.
Meu servidor pode estar entregando o arquivo errado?
Pode. A Common Crawl encontrou 136.578 arquivos robots.txt servidos no caminho do llms.txt, cerca de 10% das respostas com HTTP 200. Vale abrir o endereço no navegador e conferir qual conteúdo aparece.