
Toda discussão sobre desacelerar o desenvolvimento da inteligência artificial esbarra no mesmo obstáculo: ninguém fora dos laboratórios sabe a que velocidade a coisa anda. Reguladores debatem no escuro, pesquisadores independentes trabalham com estimativas e o público recebe declarações de executivos que mudam conforme a conveniência do trimestre.
Em 17 de setembro, a Anthropic decidiu abrir três janelas. A empresa publicou um documento com medições que ajudam a entender o ritmo do desenvolvimento de IA dentro de laboratórios de fronteira, acompanhado de um retrato numérico da própria operação. A proposta é que qualquer desenvolvedor possa publicar os mesmos indicadores e que terceiros possam verificá-los.
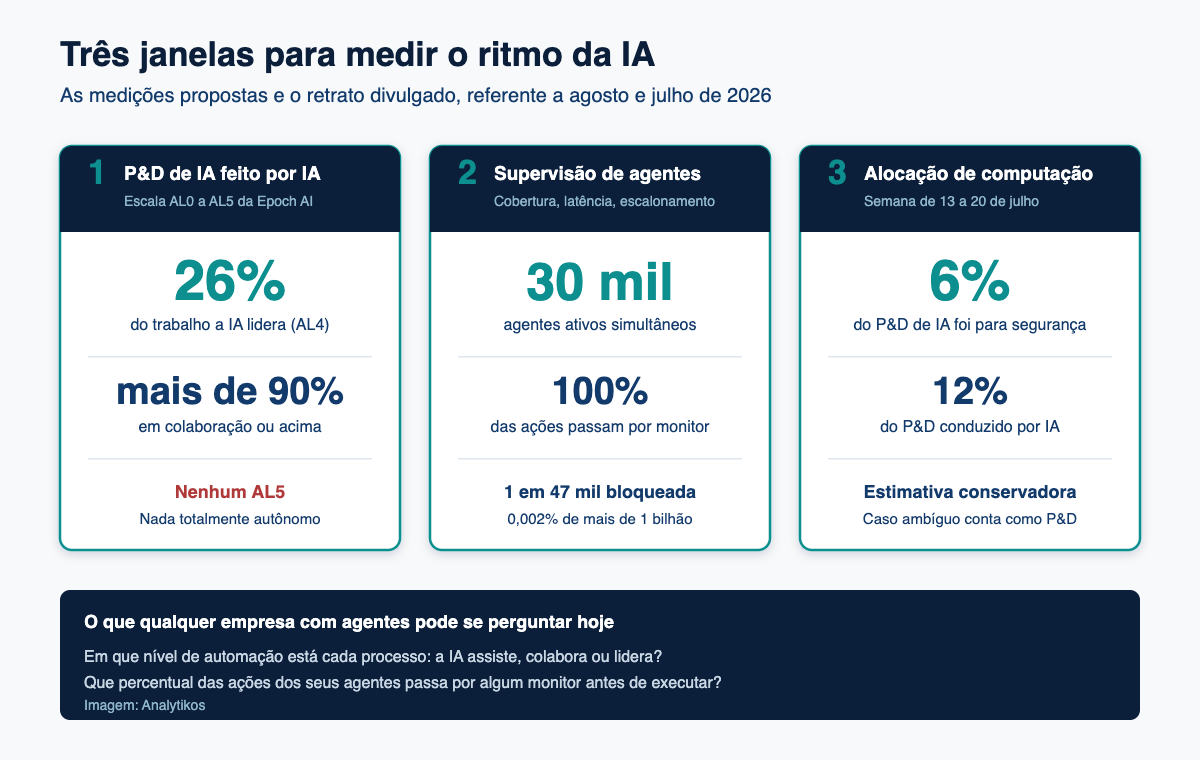
O número que vai render mais manchete: em agosto de 2026, a IA da própria empresa já liderava 26% do trabalho de pesquisa e desenvolvimento de IA feito lá dentro. E mais de 90% do trabalho está no nível de colaboração ou acima dele. O anúncio repercutiu rápido no Brasil, como noticiou o Olhar Digital.
Medição 1: quanto da IA já é construída por IA
A empresa construiu um protótipo chamado Anthropic R&D Automation Index. O método é trabalhoso: catalogar todo tipo de trabalho de P&D feito na companhia, avaliar quão automatizada está cada tarefa e agregar essas avaliações.
Para classificar, foi adotada uma escala de níveis de automação desenvolvida pela Epoch AI, que vai de AL0, sem qualquer envolvimento de IA, até AL5, quando a IA opera de forma totalmente autônoma e sem humano no circuito. No nível AL3 a IA colabora, executando grandes blocos de trabalho sob direção humana próxima. No AL4 ela lidera, concluindo a maior parte da tarefa de ponta a ponta a partir de uma instrução de alto nível, com o humano supervisionando.
| Indicador, agosto de 2026 | Resultado |
|---|---|
| Trabalho de P&D em que a IA opera totalmente sozinha (AL5) | Nenhum subconjunto medido |
| Trabalho de P&D em que a IA lidera (AL4) | 26% |
| Trabalho no nível de colaboração ou acima (AL3 ou mais) | Acima de 90% |
A metodologia merece atenção porque explica os limites do número. A cada semana de julho de 2026, 20% do pessoal de cada departamento do ciclo de P&D foi amostrado aleatoriamente. Um agente revisou o trabalho de cada pessoa a partir de registros internos, gerando uma lista de cerca de 15 mil tarefas, organizadas depois numa árvore com 542 nós, dos quais 378 são folhas. Essa árvore fica congelada para que toda medição futura ocorra contra a mesma cesta de trabalho.
Os próprios autores reconhecem dois obstáculos para comparação entre laboratórios: falta uma metodologia comum e a empresa usa os próprios modelos para avaliar os próprios sistemas, o que cria o risco de o juiz cometer os mesmos erros do avaliado. Na verificação, o modelo juiz concordou com humanos aproximadamente tanto quanto humanos concordaram entre si, com 59% de concordância exata entre modelo e humano contra 35% entre humanos, e 97% das avaliações ficaram dentro de um nível de diferença.
Medição 2: quem vigia os agentes
Este é o número que dá a real dimensão da escala. Em agosto de 2026, havia aproximadamente 30 mil agentes fazendo trabalho de pesquisa e engenharia na plataforma interna mais usada da empresa, a qualquer momento.
As ações desses agentes passam por dois tipos de monitor. Os monitores online checam em tempo real e bloqueiam ou redirecionam ações perigosas que não poderiam ser desfeitas, como um agente copiar pesos de modelo para fora dos sistemas. Os monitores offline leem as atividades depois do fato, mirando comportamentos que se desenvolvem devagar e podem ser revertidos, como sinais de desalinhamento.
| Métrica | Monitores online | Monitores offline |
|---|---|---|
| Cobertura | 100% das ações passam antes da execução | 100% das ações são ingeridas depois de tomadas |
| Latência de revisão | Revisão automática antes da ação; humanos revisam bloqueios em até uma semana | Cerca de 100 mil transcrições sinalizadas por semana, com aproximadamente 50 escalando para revisão humana |
| Taxa de bloqueio ou escalonamento | 0,002% de mais de um bilhão de decisões, cerca de 1 em 47 mil | Entre uma e duas transcrições a cada mil |
O argumento por trás da medição é estatístico e vale para qualquer empresa que esteja colocando agentes para trabalhar. Nos dados de monitoramento, agentes individuais raramente se comportam mal. Mas quando existem milhões ou bilhões de agentes operando na economia, até eventos raros passam a acontecer com regularidade. É a mesma lógica de governança que discutimos quando Amodei defendeu pisar no freio e Altman concordou.
Medição 3: para onde vai o poder de computação
A terceira janela olha para o insumo mais verificável de todo o processo. A empresa examinou um retrato de como usou toda a sua computação entre 13 e 20 de julho, classificando cada carga de trabalho e perguntando quanto da computação destinada a P&D de IA foi para trabalho de segurança.
O resultado: cerca de 6% da computação que foi para P&D de IA ficou alocada em segurança, e cerca de 12% da computação destinada a P&D conduzida por IA também. São estimativas deliberadamente conservadoras, porque um token que avançava capacidade tanto quanto segurança não era contado como segurança.
Há uma ressalva importante que o próprio documento faz: computação é um indicador imperfeito de foco em segurança. Pesquisa de segurança costuma consumir menos computação por natureza, já que consiste em pesquisadores desenhando experimentos, o que demanda tempo mas não necessariamente muitos chips. O valor da métrica está menos nos números absolutos e mais na possibilidade de comparar o mesmo indicador entre empresas e ao longo do tempo.
Por que isso interessa a quem não constrói modelos
É tentador ler esse documento como assunto interno de laboratório. Não é. Três desdobramentos afetam diretamente quem contrata, integra ou depende de IA em operação.
O primeiro é o vocabulário. A escala AL0 a AL5 da Epoch AI oferece uma linguagem comum para descrever automação que serve muito além de P&D de modelos. Perguntar em que nível está cada processo da sua operação, se a IA assiste, colabora ou lidera, é um exercício de diagnóstico mais útil do que perguntar se a empresa usa IA.
O segundo é o conjunto de métricas de supervisão. Cobertura, latência de revisão e taxa de escalonamento são indicadores que qualquer empresa rodando agentes deveria conseguir responder sobre a própria operação. Se você tem agentes tomando ações em sistemas de produção e não sabe qual percentual dessas ações passa por algum monitor, o problema não é de fronteira tecnológica, é de governança básica.
O terceiro é o precedente de auditoria. A empresa afirma que pretende inserir avaliadores terceiros independentes de múltiplas organizações, com acesso a processos, sistemas e dados internos comparável ao que as equipes internas de avaliação de risco possuem. Se essa prática pegar, o mercado ganha um padrão de verificação que hoje não existe, e a conversa sobre regulação sai do campo da declaração pública.
Conforme o mundo considera pacear a fronteira, devemos fazer todo o possível para minimizar a lacuna entre o que os laboratórios de fronteira sabem e o que o público sabe.
Anthropic, na conclusão do documento sobre as três medições
A empresa ressalva que espera que esses números mudem caso haja coordenação para pacear o desenvolvimento na fronteira. E reconhece limitações honestas em cada medição: a cesta de tarefas está congelada, o monitoramento de agentes tem meses e não anos de prática, e a classificação entre trabalho de segurança e de capacidade é difícil porque a fronteira entre as duas categorias não é preto no branco.
Nada disso resolve o debate sobre velocidade e risco. Mas transforma uma discussão que vinha sendo travada com adjetivos numa discussão com números que outros podem contestar, reproduzir ou refutar. Para um setor acostumado a medir o próprio progresso por demonstração de produto, é uma mudança de método que vale acompanhar.
Perguntas frequentes
Quais são as três medições propostas pela Anthropic?
Quanto do trabalho de pesquisa e desenvolvimento de IA é feito por IA, quão bem os agentes de IA são supervisionados e como o poder de computação é alocado, especialmente a fatia destinada a trabalho de segurança.
O que significa dizer que a IA lidera 26% do P&D?
Significa que, na escala de automação da Epoch AI, 26% do trabalho está no nível AL4, em que a IA conclui a maior parte da tarefa de ponta a ponta a partir de uma instrução de alto nível, com supervisão humana. Nenhum subconjunto medido atingiu o nível totalmente autônomo.
Quantos agentes de IA a Anthropic tem operando internamente?
Aproximadamente 30 mil agentes fazendo trabalho de pesquisa e engenharia a qualquer momento na plataforma interna mais usada, em agosto de 2026. As medições divulgadas cobrem apenas essa plataforma.
Quanto da computação vai para segurança?
Cerca de 6% da computação destinada a P&D de IA e cerca de 12% da computação destinada a P&D conduzido por IA, na semana de 13 a 20 de julho de 2026. São estimativas conservadoras, já que trabalho ambíguo foi classificado como P&D e não como segurança.
Outras empresas podem publicar os mesmos números?
Segundo o documento, sim. A proposta é justamente que qualquer desenvolvedor de fronteira publique essas medições com metodologia pública, permitindo comparação ao longo do tempo e entre laboratórios, com verificação por terceiros independentes.