
Na manhã de 16 de setembro o Salesforce parou em várias regiões ao mesmo tempo. Login falhando, latência alta, erros intermitentes e, em alguns casos, impossibilidade de acessar a plataforma. O detalhe cruel é que o incidente caiu bem no meio do Dreamforce 2026, a semana em que a empresa apresenta seus maiores anúncios do ano, conforme acompanhou o Salesforce Ben minuto a minuto.
O alcance foi amplo. Relatos vieram dos Estados Unidos, Japão, Índia, Reino Unido, França, Alemanha e também de Austrália, Brasil, Canadá, Itália, Coreia do Sul, Cingapura e Suécia, segundo apuração do The Register. Pior: o próprio portal de suporte ficou comprometido, o que impediu parte dos clientes de abrir chamado enquanto o problema acontecia.
O serviço voltou em pouco mais de três horas. O que não volta em três horas é a resposta que todo plano de continuidade do CRM deveria dar: o que a sua operação faz nas próximas duas horas quando o CRM some? Este texto é sobre isso, não sobre culpar o fornecedor.
O que aconteceu, em ordem
O Salesforce reconheceu a interrupção às 00h50 no fuso do Pacífico e confirmou pouco antes das 2h que instâncias de todas as regiões estavam afetadas. O diagnóstico foi mudando ao longo da madrugada, o que é normal em incidente de escala.
| Horário (PDT) | O que o fornecedor comunicou |
|---|---|
| 00h50 | Primeiro reconhecimento da interrupção no Salesforce Trust. |
| 02h10 | Requisições travando à espera de resposta de um serviço interno de login, consumindo recursos de servidor. |
| 02h57 | Suspeita de falha em dependência externa ligada ao servidor de login legado. Endpoint de API bloqueado como mitigação. |
| 03h18 | Carga elevada em um componente central limitando a capacidade de processar requisições. |
| 03h56 | Correção validada em instância de teste e início do rollout. |
| 04h19 | Rollout em toda a frota. Serviço começa a normalizar, com correção definitiva em código ainda pendente. |
Vale notar o que a própria empresa descreveu: o gargalo não estava no CRM em si, mas em uma camada de autenticação e em uma dependência de terceiros. Isso é exatamente o tipo de falha que nenhum cliente consegue prever olhando apenas o SLA contratado.
As requisições estão travando enquanto aguardam resposta de um serviço interno de login, o que acaba consumindo os recursos de servidor disponíveis.
Salesforce, atualização publicada no Salesforce Trust em 16 de setembro de 2026
O que o incidente expõe na operação de CRM
A leitura preguiçosa é dizer que nuvem falha. A leitura útil é outra: quanto mais a operação comercial e de atendimento migra para dentro de uma única plataforma, mais a continuidade do CRM vira risco concentrado. E essa concentração vem crescendo rápido.
Basta olhar o movimento recente do próprio fornecedor. O Salesforce passou a dar nome e cargo aos agentes de IA do Agentforce e a colocar o CRM dentro do assistente de IA com o Claudeforce. São avanços reais de produtividade, mas cada um deles aumenta o número de rotinas que simplesmente não existem quando a plataforma sai do ar. Já tratamos dessa lógica quando a suspensão de um modelo de IA virou aula sobre dependência de stack.
Três consequências práticas aparecem em toda queda desse tipo. A primeira é operacional: ninguém consegue registrar o que está acontecendo. A segunda é comercial: propostas, follow ups e fechamentos param. A terceira é a mais cara e a menos comentada, que é a de reputação com o cliente final.
Quatro camadas de continuidade do CRM que precisam estar escritas
Plano de continuidade do CRM não é documento de TI. É documento de operação, e precisa caber em uma página que qualquer pessoa do time consiga executar sem pedir ajuda.
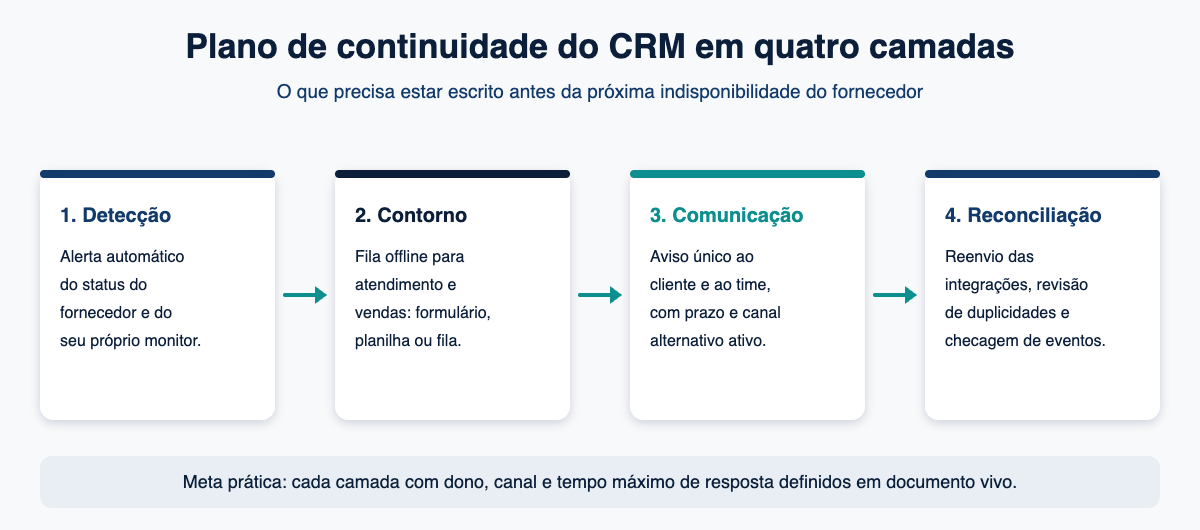
- Detecção. Assine a página de status do fornecedor e cruze com um monitor próprio. Depender do time perceber que o sistema está lento custa os primeiros trinta minutos, que são os mais valiosos.
- Contorno. Tenha uma fila offline pronta: formulário simples, planilha compartilhada ou canal dedicado onde atendimento e vendas registram o que acontecer. O objetivo não é substituir o CRM, é não perder o registro.
- Comunicação. Uma mensagem só, alinhada, para cliente e para time, com prazo estimado e canal alternativo ativo. Silêncio durante indisponibilidade é o que vira reclamação pública.
- Reconciliação. Quando o sistema volta, alguém precisa reenviar integrações, procurar duplicidades criadas no contorno e conferir se os eventos de automação dispararam duas vezes ou nenhuma.
Cada camada precisa de dono, canal e tempo máximo de resposta. Sem isso, o documento vira teoria.
O erro mais caro é o silêncio com o cliente
Durante a queda, usuários relataram ter de avisar clientes de que o sistema estava indisponível e acumular fila de retornos. É aí que o custo real aparece. O cliente não sabe nem se importa com qual fornecedor falhou. Ele registra que a sua empresa não respondeu.
É o mesmo princípio que discutimos ao tratar da leitura de sinais comportamentais em vez de pesquisas de satisfação: a insatisfação raramente chega como reclamação formal. Ela chega como ausência. Uma indisponibilidade de três horas, mal comunicada, entra no mesmo balde.
Como testar a continuidade do CRM antes do próximo incidente
Testar a continuidade do CRM não exige simulação elaborada. Precisa de constância.
- Marque uma janela de trinta minutos por trimestre e rode o cenário como se a plataforma estivesse fora. Cronometre quanto tempo o time leva para chegar ao contorno.
- Valide se a fila offline realmente captura os campos obrigatórios do seu funil. Faltar telefone ou origem do lead inviabiliza a reconciliação depois.
- Cheque quem tem permissão para disparar a comunicação ao cliente. Se a resposta for uma pessoa só, você tem um ponto único de falha humano além do técnico.
- Revise a arquitetura em busca de dependências que você não controla. Uma retenção componível com módulos conectados por API distribui o risco melhor do que um monólito, desde que os módulos não compartilhem o mesmo login.
- Documente quem é a pessoa responsável por operar essa ponte. Em times mais maduros, esse papel já se parece bastante com o novo perfil de gestor de contact center com IA.
O Salesforce voltou ao ar no mesmo dia e segue sendo a plataforma mais usada do mercado. A pergunta que fica não é se vale a pena usá-la. É se a sua operação sabe o que fazer nas três horas em que ela não está disponível.
Perguntas frequentes
O que causou a queda do Salesforce em 16 de setembro de 2026?
Segundo as atualizações publicadas pela própria empresa no Salesforce Trust, requisições travavam aguardando resposta de um serviço interno de login e consumiam os recursos de servidor. A empresa apontou falha em dependência externa ligada ao servidor de login legado e carga elevada em um componente central.
Quanto tempo durou a indisponibilidade?
O primeiro reconhecimento ocorreu às 00h50 no fuso do Pacífico e o rollout da correção em toda a frota começou por volta das 04h19, com normalização progressiva do serviço. A correção definitiva em código ficou para depois.
Clientes brasileiros foram afetados?
Sim. Houve relatos de impacto no Brasil, além de Estados Unidos, Japão, Índia, Reino Unido, França, Alemanha e outros mercados, conforme apuração da imprensa especializada.
O que é um plano de continuidade do CRM?
É o documento que define o que a operação faz quando a plataforma fica indisponível. Ele cobre detecção do incidente, contorno operacional para não perder registros, comunicação com cliente e time e reconciliação dos dados quando o sistema volta.
Faz sentido trocar de fornecedor depois de uma queda dessas?
Raramente. Indisponibilidade acontece em qualquer nuvem, e migração de CRM costuma custar mais do que o incidente. O aprendizado útil é reduzir a concentração de processos críticos em um único ponto e ter um contorno testado.