Existe um slide rodando em quase toda empresa que adotou IA: uma linha caindo, o preço do token despencando, a promessa de que automação com agentes vai ficar barata. A linha é verdadeira. A conclusão não.
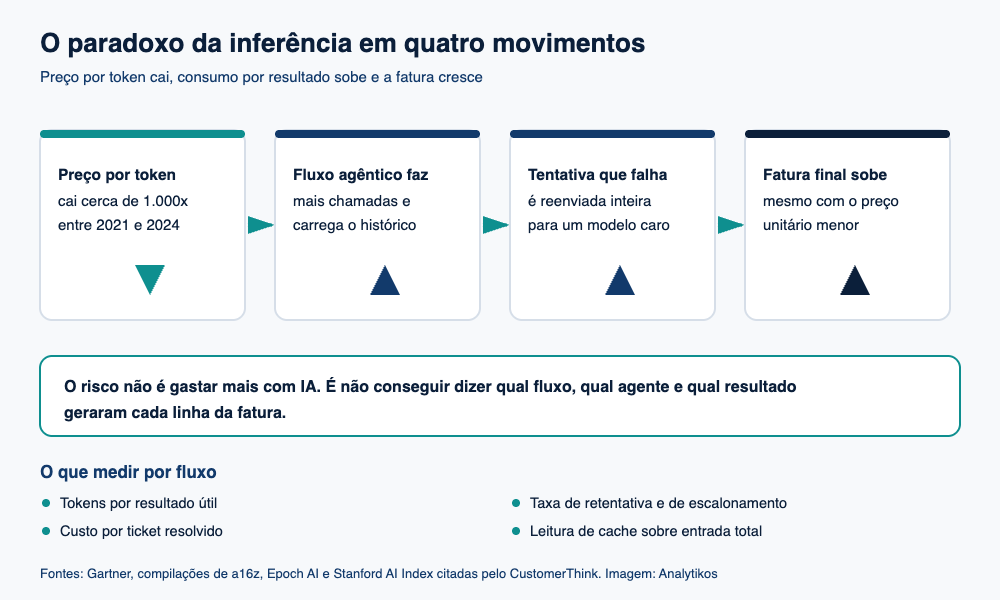
O motivo é que ninguém compra token. Compra fluxo de trabalho. E fluxo agêntico aprendeu a consumir token mais rápido do que o token barateia. O analista de CRM Thomas Wieberneit chamou isso de paradoxo da inferência, reunindo dados do Gartner, compilações de a16z, Epoch AI e do AI Index de Stanford, além de pesquisas acadêmicas recentes.
Para quem opera IA em marketing, atendimento ou e-commerce, o efeito prático é direto: o preço unitário cai, o consumo por resultado sobe e a fatura fecha maior. Nenhum dos dois números está errado.
A queda de preço aconteceu na ponta errada
Os dados compilados mostram que a qualidade equivalente ao GPT-3 custava por volta de 60 dólares por milhão de tokens no fim de 2021 e cerca de 0,06 dólar no fim de 2024. Uma queda de mil vezes, com o custo por desempenho melhorando em ritmo mediano de 50 vezes ao ano.
Só que o colapso aconteceu na ponta de commodity. O preço da inteligência do ano passado desabou. O da inteligência deste ano, não. A tabela pública da Anthropic coloca o Claude Opus 5 em 5 dólares por milhão de tokens de entrada e 25 de saída, com o modo rápido pelo dobro. Esses são exatamente os modelos para onde um fluxo agêntico escala quando o modelo barato falha.
| Camada | Preço por milhão de tokens | Quem usa |
|---|---|---|
| Qualidade equivalente ao GPT-3, fim de 2021 | Cerca de 60 dólares | Referência histórica |
| Mesma qualidade, fim de 2024 | Cerca de 0,06 dólar | Tarefa simples e classificação |
| Fronteira atual, entrada | 5 dólares | Raciocínio, exceção e decisão |
| Fronteira atual, saída | 25 dólares | Geração longa e resposta final |
Arquiteturas agênticas são desenhadas para usar a fronteira. É aí que a economia se inverte.
Inflação de tokens: o número que ninguém orça
A pesquisa acadêmica já deu nome ao efeito. O estudo Not All Tokens Are Equal chama de inflação de tokens a distância entre o preço anunciado por token e o que o fluxo realmente consome depois de repetir o que errou. A medição chega a 4,25 vezes em perguntas que exigem múltiplos passos.
O mecanismo é o que pega. Uma cadeia de raciocínio que falha não é apenas uma chamada perdida: é uma chamada reenviada inteira, com todo o histórico junto, para um modelo mais caro. Pior, os autores mostram que encaminhar uma cadeia que já falhou para um modelo mais forte chegou a custar 34,8 pontos percentuais de acurácia.
Do lado da infraestrutura, o estudo The Cost of Dynamic Reasoning mediu o que agentes fazem com a fila de atendimento do modelo. Agentes com ferramentas fazem cerca de 9,2 vezes mais chamadas do que uma linha de raciocínio simples. Um agente que faz busca em árvore chega a 71 chamadas por pedido. E a GPU passa 54,5% do tempo ociosa esperando resposta de ferramenta.
Pensar demais piora a resposta e ainda custa mais
Existe uma linha de custo que quase ninguém coloca no orçamento: o ponto a partir do qual gastar mais raciocínio degrada o resultado.
O estudo When More Thinking Hurts mostra que o ganho marginal cai de 1,8% a cada 500 tokens na faixa de 2 mil a 4 mil para 0,1% entre 8 mil e 12 mil, e vira negativo depois disso. Passado cerca de 7 mil tokens, o modelo transforma mais respostas certas em erradas do que o contrário. Em problemas simples, o excesso começa por volta de 1.500 tokens.
Traduzindo para a operação: nas tarefas fáceis, que são a maioria do volume de atendimento, você paga mais para receber pior. É o oposto do que o painel de custo costuma sugerir.
A mesma lógica já apareceu quando a Anthropic passou a oferecer um seletor de esforço no Claude Opus 5. Controlar quanto o modelo pensa deixou de ser detalhe técnico e virou linha de custo.
O contrato esconde o multiplicador
Nada disso apareceria na fatura se a cobrança fosse legível. Não é. O levantamento do CustomerThink cataloga seis modelos vivos de precificação em plataformas de atendimento: por assento com tokens embutidos, por canal, por componente, por crédito, por ação e por resolução.
| Modelo de cobrança | Onde o multiplicador se esconde | Pergunta a fazer ao fornecedor |
|---|---|---|
| Por mensagem ou por minuto | O agente gera novo contato e você paga duas vezes por uma falha | Contato repetido em 24 horas conta como nova cobrança? |
| Por resolução | Cria incentivo para o fornecedor não escalar para um humano | O que conta como resolvido e quem audita esse número? |
| Por ação ou crédito | Exige modelar o fluxo inteiro antes de prever o trimestre | Quantas ações uma conversa média consome hoje? |
| Por assento com tokens embutidos | O teto de token não aparece até ser ultrapassado | Qual é o limite e qual o preço do excedente? |
É o mesmo problema de opacidade que já vimos em outro canal, quando seis meses de ChatGPT Ads passaram sem ninguém saber o que é um bom CPC. Quando o denominador não é público, planejamento vira aposta.
O problema não é gastar. É não saber onde
Consumo maior com preço unitário menor é o que Jevons descreveu para o carvão, o aço e a banda larga. Costuma indicar tecnologia que funciona. Gastar mais com inferência em 2029 do que hoje não é, por si só, má gestão.
A falha é mais estreita: gasto não atribuído. As empresas em apuros não são as que têm fatura alta. São as que não conseguem dizer qual fluxo, qual agente e qual ticket resolvido pertencem a cada linha da conta. Isso conversa com o achado de que só 13% extraem valor real da IA comercial: sem atribuição, não há como provar retorno.
Os tokens vão continuar ficando mais baratos. A conta vai continuar ficando maior. Só um desses dois está sob o seu controle.
Thomas Wieberneit, consultor de CRM, no CustomerThink
Cinco controles antes de escalar
- Instrumente antes de crescer. Telemetria de token por agente e por fluxo, com alerta de limite, desde o piloto. Custo que você não atribui é custo que você não defende nem evita.
- Limite os laços. Teto rígido de tentativas com escalonamento obrigatório para uma pessoa, e política de recomeçar do zero em vez de encaminhar a cadeia que já falhou.
- Orce o raciocínio. Teto de tokens de raciocínio por tarefa, alocado por dificuldade e não de forma uniforme. Acima do ponto de virada, você compra degradação a preço cheio.
- Use os descontos de engenharia. Leitura de cache custa uma fração da entrada padrão. Roteie tarefa simples para modelo pequeno, compacte contexto e pare de enviar todo o esquema de ferramentas em toda chamada.
- Coloque o medidor no contrato. Unidade cobrável definida por escrito, incluindo token em cache, execução de ferramenta, chamadas que falharam e retentativas, além de direito de auditoria e aviso prévio antes de qualquer mudança de preço.
E lembre que nem todo estouro vem de volume. Um obstáculo bobo pode consumir orçamento inteiro em silêncio, como no caso em que um CAPTCHA travou um agente por 150 páginas. Sem telemetria, isso aparece só na fatura.
Perguntas frequentes
O que é o paradoxo da inferência?
É a situação em que o preço por token cai de forma acentuada enquanto a fatura de IA sobe, porque o fluxo agêntico consome muito mais tokens por resultado útil do que uma chamada única.
Por que a queda de preço não reduz a minha conta?
Porque a queda aconteceu na camada de commodity. Fluxos agênticos escalam para modelos de fronteira quando o modelo barato falha, e esses continuam caros.
O que é inflação de tokens?
É a distância entre o preço anunciado por token e o consumo real do fluxo depois de repetir o que errou. A pesquisa mede o efeito em até 4,25 vezes em tarefas de múltiplos passos.
Gastar mais raciocínio melhora sempre a resposta?
Não. A partir de certo ponto o ganho marginal vira negativo e o modelo converte mais respostas certas em erradas. Em tarefas simples, isso começa cedo, por volta de 1.500 tokens.
Qual é o primeiro controle a implementar?
Telemetria por agente e por fluxo. Sem saber qual processo gerou qual custo, nenhum outro controle pode ser priorizado com segurança.