
A OpenAI demitiu contratados que trabalhavam justamente para treinar e avaliar as respostas do ChatGPT depois de descobrir que eles usavam ferramentas de inteligência artificial para fazer o próprio trabalho de avaliação. O caso, revelado pela investigação do 404 Media e repercutido pelo Search Engine Roundtable, expõe um paradoxo que preocupa quem depende de IA para tomar decisão de negócio: a própria empresa que treina os modelos está demitindo gente por usar IA no trabalho de treinar esses modelos.
O episódio envolve o Project Lily e programas de contratados relacionados, que reúnem milhares de avaliadores humanos responsáveis por revisar prompts de usuários e respostas do ChatGPT, um trabalho conhecido no setor como “quality rating” ou avaliação de qualidade de dados de treinamento.
Como os avaliadores foram flagrados
Segundo a apuração do 404 Media, supervisores identificaram padrões clássicos de texto gerado por IA nas avaliações entregues: linguagem repetitiva, uso excessivo de travessões e tempo de conclusão das tarefas rápido demais para ser plausível em uma revisão humana cuidadosa. Em canais internos de Slack, era comum ver contratados perguntando a colegas se determinada avaliação parecia “feita por IA”, e as respostas costumavam confirmar a suspeita.
A política interna da OpenAI para esse tipo de trabalho é direta: “não use ferramentas de detecção de IA, nem IA você mesmo”. A regra proíbe explicitamente softwares como GPTZero, Grammarly e serviços de tradução automática na hora de escrever ou revisar feedback.
O paradoxo do treinamento de IA por IA
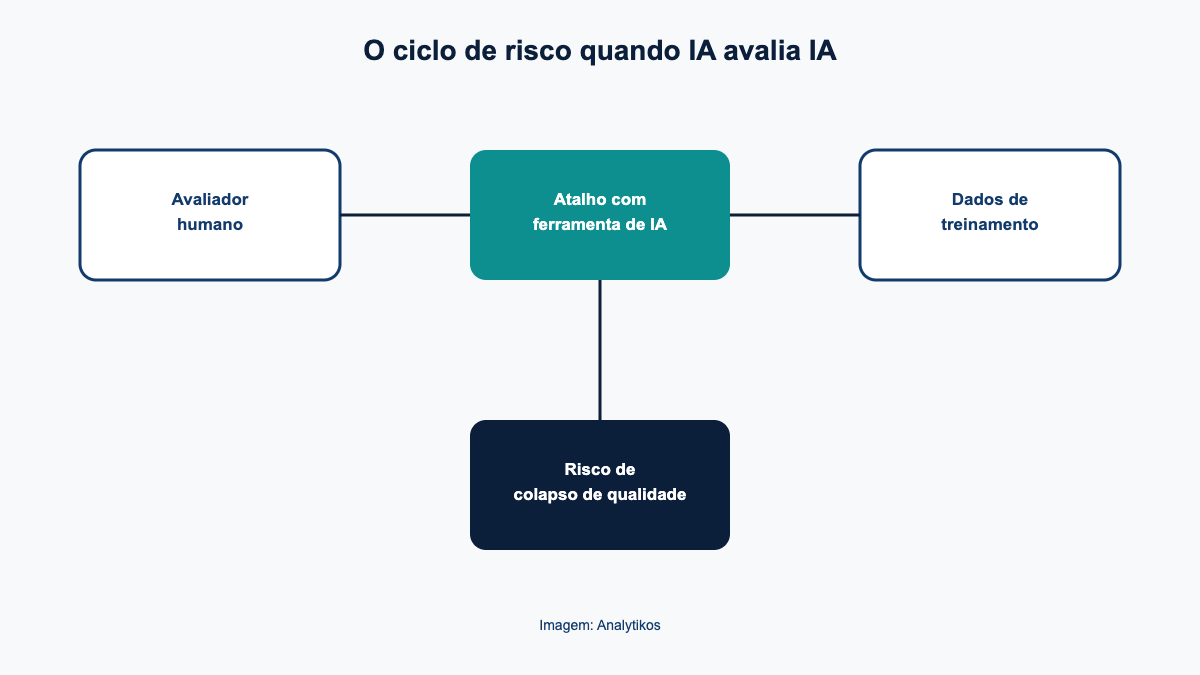
O caso ilustra um risco que especialistas em qualidade de dados chamam de colapso de modelo: quando um sistema de IA é treinado, direta ou indiretamente, com dados gerados por outra IA, a qualidade tende a degradar ao longo do tempo, reforçando vieses e reduzindo a diversidade de respostas. É exatamente esse risco que torna a avaliação humana de prompts e respostas tão sensível, e por isso empresas como a OpenAI tratam o uso de IA nesse processo como falta grave.
O tema conversa diretamente com outro movimento recente do setor: a Anthropic contratando a Accenture para atuar como avaliadora embarcada de seus modelos, em um esforço parecido de manter humanos qualificados no centro do processo de avaliação de IA.
“Eu não sou uma pessoa ruim nem uma profissional ruim. Só precisei de uma ajudinha e recorri à IA, o que acabou levando à minha demissão.”
Contratado demitido do programa de avaliação da OpenAI, em depoimento ao 404 Media
Por que isso importa para quem usa IA no marketing e no atendimento
Empresas que usam modelos como o ChatGPT para atendimento, geração de conteúdo ou análise de dados dependem, no fim da cadeia, da qualidade do treinamento por trás desses modelos. Se o próprio processo de avaliação humana está sob pressão para ser mais rápido, e alguns avaliadores recorrem a atalhos com IA, a confiabilidade das respostas do modelo no dia a dia também pode ser afetada, principalmente em tarefas que exigem nuance e julgamento humano genuíno.
Isso reforça um ponto que já destacamos ao comentar o estudo sobre IA que inventa respostas com confiança: quanto mais a cadeia de treinamento e avaliação depende de atalhos automatizados, maior o risco de erros difíceis de detectar chegarem ao usuário final.
O que fazer diante desse cenário
Para times que dependem de modelos de IA generativa no dia a dia, a recomendação prática é não tratar a saída do modelo como verdade absoluta em tarefas críticas. Vale manter revisão humana em decisões de alto impacto, testar respostas de IA com casos de borda conhecidos periodicamente e acompanhar publicamente como fornecedores de IA (OpenAI, Anthropic, Google) estão lidando com a qualidade dos seus próprios processos de avaliação, já que isso impacta diretamente a confiabilidade do produto final.
Perguntas frequentes
O que aconteceu com os avaliadores da OpenAI?
Contratados responsáveis por avaliar respostas do ChatGPT foram demitidos após serem flagrados usando ferramentas de IA para realizar o próprio trabalho de avaliação, o que violava a política interna da empresa.
Por que a OpenAI proíbe o uso de IA nessa função?
Porque o trabalho de avaliação humana serve justamente para garantir qualidade e critério humano no treinamento dos modelos. Usar IA para essa tarefa pode gerar o chamado colapso de modelo, com degradação de qualidade ao longo do tempo.
Como os avaliadores foram descobertos?
Supervisores notaram padrões de linguagem típicos de texto gerado por IA e tempos de conclusão de tarefa incompatíveis com uma revisão humana cuidadosa.
Isso afeta a qualidade do ChatGPT para quem usa no dia a dia?
O caso levanta essa preocupação, já que a avaliação humana de qualidade é parte central do processo de treinamento e ajuste fino dos modelos de IA generativa.
Outras empresas de IA têm problemas parecidos?
O caso da OpenAI acontece em paralelo a movimentos como o da Anthropic, que contratou a Accenture para reforçar a avaliação humana embarcada de seus modelos.