
Quando você digita uma pergunta ampla no AI Mode ou recebe uma IA Overview no Google, o que parece uma resposta única, na verdade, é o resultado de várias buscas menores rodando por trás dos panos. Esse mecanismo se chama “query fan-out” (expansão de consultas) e, até pouco tempo atrás, era um dos maiores gargalos técnicos da busca com IA: gerar e responder dezenas de sub-consultas para montar uma única resposta tem um custo computacional alto, o que limitava quantas buscas podiam receber esse tratamento em escala.
Em setembro de 2026, o Google apresentou o R4T-Diffusion (Retrieve-for-Train), um framework que promete resolver justamente esse gargalo. Segundo a cobertura da Search Engine Journal, o modelo reduz a latência da expansão de consultas em até 12 a 20 vezes, usando um “diffusion retriever” treinado por reforço. Na prática, isso significa que o fan-out, antes caro demais para rodar em toda busca, passa a ser viável em muito mais consultas, com muito mais velocidade.
Para quem trabalha com SEO e GEO (otimização para mecanismos de IA), essa não é só uma notícia de bastidor técnico. É um sinalizador direto de para onde a busca está indo: mais respostas de IA, mais abrangentes, construídas a partir de mais sub-perguntas respondidas por mais fontes. Entender como isso funciona, e o que fazer a respeito, é o que separa quem vai continuar sendo recuperado nessas respostas de quem vai ficar de fora.
O que é query fan-out e por que o Google depende dele
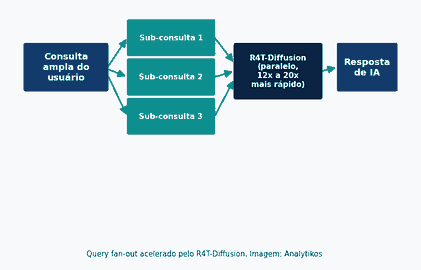
Query fan-out é a técnica pela qual um sistema de busca pega uma pergunta ampla, do tipo “equipamento de camping”, e a decompõe em várias sub-consultas mais específicas (barraca, saco de dormir, fogareiro, lanterna de cabeça) em vez de devolver dez variações do mesmo item. O objetivo é montar uma resposta final diversa e completa, e não uma lista redundante de resultados parecidos.
É esse mecanismo que sustenta boa parte do que vemos hoje em IA Overviews e no AI Mode: cada resposta gerada por IA normalmente não vem de uma única recuperação de informação, mas de várias buscas paralelas, cada uma cobrindo um ângulo diferente da pergunta original. Quanto mais sub-consultas o sistema conseguir gerar e responder com qualidade, mais completa (e mais “expert”) a resposta final tende a parecer. O problema é que gerar essas sub-consultas de forma autorregressiva (uma palavra de cada vez, em sequência) é lento e caro, o que sempre limitou o fan-out a uma fração das buscas.
R4T-Diffusion: o motor por trás da velocidade
É aqui que entra o R4T-Diffusion. De acordo com a cobertura da MarkTechPost, a mais próxima da pesquisa original do Google Research, o framework funciona em duas etapas. Primeiro, um modelo de linguagem é treinado por aprendizado por reforço (reinforcement learning), de forma offline, para gerar boas sub-consultas de fan-out, recompensado pela qualidade do conjunto de resultados recuperado, não apenas por cada sub-consulta isolada. Depois, esse comportamento é “destilado” para um modelo de difusão bem mais enxuto (53,9 milhões de parâmetros), que gera todas as direções de busca de uma só vez, em uma única passada, em vez de uma sub-consulta por vez.
O ganho de velocidade: 12x a 20x
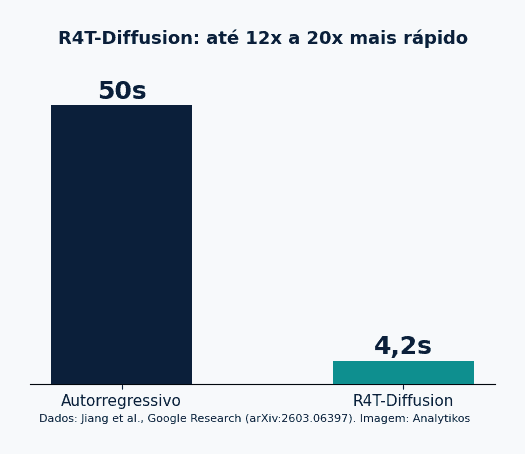
O resultado é uma aceleração de 12 a 20 vezes em relação à geração autorregressiva tradicional. Em lotes grandes, o método antigo podia levar perto de 50 segundos para gerar o fan-out completo; o modelo de difusão faz o mesmo trabalho em poucos segundos, ou até em frações de segundo. O estudo original do Google Research (Jiang et al., “Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”, arXiv:2603.06397) detalha essa curva: a latência autorregressiva sobe de cerca de 1,46 segundo em lotes pequenos para quase 50 segundos em lotes de 1024 consultas, enquanto o modelo de difusão vai de 0,07 segundo a apenas 4,21 segundos no mesmo intervalo. Como resume a Marketing Herald, o Google descreve o resultado como a entrega de “production-ready, expert-level search at a fraction of the computational cost” (busca pronta para produção, em nível especialista, por uma fração do custo computacional).
“Busca pronta para produção, em nível especialista, a uma fração do custo computacional.”
Google Research, via Marketing Herald
Essa diferença de custo é o verdadeiro divisor de águas. O problema nunca foi saber fazer fan-out de qualidade, mas rodá-lo em volume sem estourar o orçamento de infraestrutura. Com um modelo 12 a 20 vezes mais rápido, o fan-out deixa de ser reservado a casos excepcionais e passa a ser aplicável em escala muito maior, o que é justamente o que torna a IA generativa do Google mais abrangente.
Por que isso importa para quem faz SEO e GEO
Se o fan-out passa a rodar em mais buscas, com mais sub-consultas geradas por resposta, a implicação prática para conteúdo é direta: uma página não é mais avaliada apenas pela pergunta principal que ela responde, mas pelo conjunto de sub-perguntas que aquele tema naturalmente gera. Como aponta o The Authority Report, uma decomposição melhor do fan-out significa resultados mais diversos e menos redundantes, o que muda o padrão de que tipo de conteúdo tem chance de ser recuperado.
Cobrir a pergunta principal não basta mais
Pense em um artigo sobre “como escolher um CRM”: a pergunta principal é essa, mas o fan-out provavelmente vai gerar sub-consultas como “diferença entre CRM e planilha”, “quanto custa um CRM para pequena empresa” ou “CRM integra com WhatsApp?”. Um conteúdo que responde só ao título, sem cobrir esses desdobramentos, tende a ser recuperado em menos sub-consultas do fan-out, e, portanto, contribuir menos para a resposta final gerada pela IA.
Estrutura clara ajuda a ser encontrado em mais sub-consultas
Aqui entra um ponto que já discutimos em outros materiais sobre GEO: estrutura não é só estética, é recuperabilidade. Um artigo organizado em H2 e H3 temáticos, com respostas diretas no início de cada seção e dados concretos, tem muito mais chance de “casar” com uma sub-consulta específica do fan-out do que um texto corrido, sem hierarquia clara. Cada H2/H3 bem definido funciona quase como uma resposta pronta para uma das sub-perguntas que o sistema vai gerar.
| Aspecto | Fan-out antes do R4T-Diffusion | Fan-out com R4T-Diffusion |
|---|---|---|
| Velocidade de geração | Lenta (autorregressiva, até ~50s em lotes grandes) | 12x a 20x mais rápida (segundos ou frações de segundo) |
| Escala de aplicação | Reservada a casos específicos, por custo computacional | Viável em volume muito maior de buscas |
| Cobertura de sub-consultas | Menos sub-perguntas exploradas por resposta | Mais sub-perguntas exploradas, com maior diversidade |
| O que o conteúdo precisa fazer | Responder bem à pergunta principal | Responder à pergunta principal e às sub-perguntas do tema |
O que fazer na prática: checklist para SEO e GEO
Vale reforçar: a implantação em produção, em escala completa, ainda não foi confirmada oficialmente pelo Google, embora o intervalo de seis meses entre o paper (março de 2026) e o anúncio (setembro de 2026) sugira essa direção. Mesmo assim, a direção estratégica já está clara, e vale se antecipar. Como resume a TechWyse, o R4T-Diffusion reformula a forma como o fan-out é aplicado na busca com IA, o que já é motivo suficiente para revisar a estratégia de conteúdo agora.
- Mapeie as sub-perguntas de cada tema: antes de escrever, liste as perguntas derivadas que um leitor (ou uma IA) faria sobre o assunto, não só a pergunta “cabeçalho”.
- Estruture em H2/H3 temáticos: cada subtítulo deve corresponder a uma sub-pergunta real, com resposta direta logo no início do parágrafo.
- Traga dados, não só opinião: números, comparações e exemplos concretos “casam” melhor com uma sub-consulta específica do fan-out.
- Evite conteúdo raso sobre múltiplos tópicos: é melhor cobrir a fundo as sub-perguntas de um tema do que tangenciar vários temas de forma superficial.
- Reavalie clusters de conteúdo existentes: páginas antigas podem responder só à pergunta principal e perder cobertura nas sub-perguntas que o fan-out hoje explora.
No fim, o R4T-Diffusion não muda o que sempre foi verdade em SEO e GEO: conteúdo completo, bem estruturado e sustentado por dados tem mais chance de ser recuperado. O que muda é a escala: com o fan-out mais rápido, essa lógica passa a valer para muito mais buscas, tornando a estruturação por sub-perguntas menos um diferencial e mais um requisito básico de visibilidade.
Perguntas frequentes
O que é query fan-out no Google?
É a técnica pela qual o Google decompõe uma pergunta ampla em várias sub-consultas mais específicas, busca respostas para cada uma delas e combina os resultados em uma única resposta gerada por IA, usada em IA Overviews e no AI Mode.
O que é o R4T-Diffusion (Retrieve-for-Train)?
É um framework do Google Research que treina um modelo de fan-out por aprendizado por reforço e depois destila esse comportamento em um modelo de difusão compacto, capaz de gerar todas as sub-consultas em uma única passada, em vez de uma por vez.
Qual é o ganho de velocidade do R4T-Diffusion?
Segundo a cobertura das fontes, o R4T-Diffusion reduz a latência da expansão de consultas em 12 a 20 vezes em comparação com a geração autorregressiva tradicional, chegando a poucos segundos ou frações de segundo em vez de cerca de 50 segundos em lotes grandes.
O R4T-Diffusion já está em produção nas buscas do Google?
O anúncio confirma o framework e seus ganhos de desempenho, mas a implantação em produção, em escala completa, ainda não foi confirmada oficialmente pelo Google, embora o intervalo entre o paper e o anúncio sugira essa direção.
O que isso muda na prática para quem faz SEO e GEO?
Conteúdo precisa responder não só à pergunta principal de um tema, mas também às sub-perguntas que ele naturalmente gera, com estrutura clara em H2/H3, respostas diretas e dados concretos, para ter mais chance de ser recuperado nas sub-consultas do fan-out.