
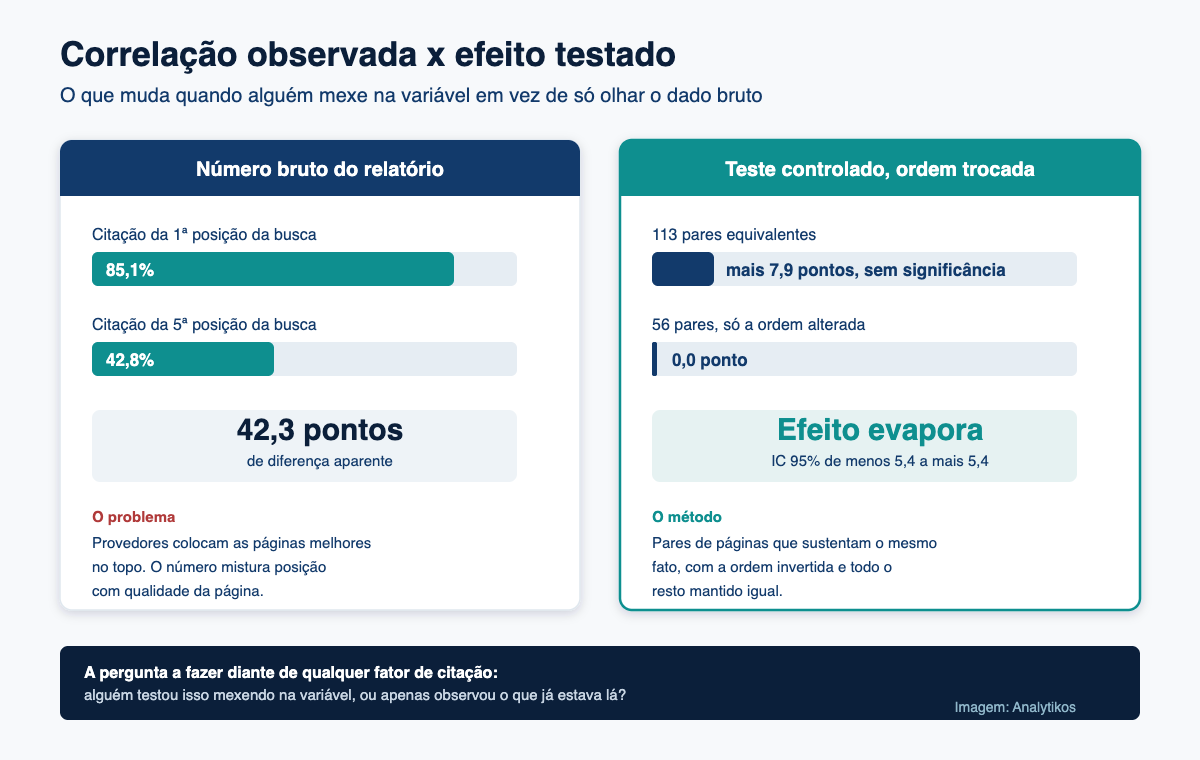
Existe uma crença confortável circulando nas apresentações de GEO: aparecer no topo da lista de fontes que o modelo consulta seria o fator decisivo para ser citado. Os números brutos parecem confirmar. Em transcrições reais de um agente de busca com IA, páginas na primeira posição da chamada de busca foram citadas em 85,1% das vezes, contra 42,8% das que ficaram em quinto lugar. Uma diferença de 42,3 pontos percentuais é o tipo de dado que vira slide.
Só que dois pesquisadores resolveram fazer o que quase ninguém faz: em vez de observar a correlação, foram lá e mexeram na variável. Sriram Selvam e Anneswa Ghosh pegaram pares de páginas que apareciam no mesmo resultado de busca e sustentavam o mesmo fato, e então inverteram a ordem entre elas, mantendo todo o resto igual. O efeito praticamente evaporou. Num teste de acompanhamento, deu exatamente zero.
O estudo foi publicado no arXiv em 14 de setembro sob o nome CITECHOICE: A Causal Audit of How Document Presentation Redistributes Citation Credit in Agentic Search, ainda sem revisão por pares. E ele diz algo incômodo para o mercado de otimização para IA: boa parte do que chamamos de fator de citação pode ser apenas a sombra de outra coisa.
Como o teste foi montado
Os pesquisadores pediram a um agente de busca baseado em GPT-5.4, usando a Exa como provedor, que respondesse 130 perguntas comuns fazendo pesquisas próprias na web. Foram registradas todas as mensagens e todos os resultados das 129 perguntas efetivamente respondidas.
A partir dessas transcrições, eles selecionaram pares de páginas que apareciam no mesmo resultado e sustentavam o mesmo fato, ou seja, situações em que qualquer uma das duas poderia ser citada com justiça. Sobraram 113 pares, e uma checagem humana às cegas confirmou 103 deles como equivalentes de verdade. Quando o par é legítimo, qualquer diferença de crédito vem de como o modelo distribui reconhecimento entre duas fontes que dizem a mesma coisa.
Cada conversa salva foi reproduzida de quatro maneiras, colocando uma página acima ou abaixo da outra e exibindo o texto ora como parágrafos corridos, ora reescrito com títulos e listas ou em tabela. Só a resposta final era gerada de novo. Vale registrar uma limitação que os próprios autores apontam: as duas versões foram reescritas por IA, então a comparação é entre duas reescritas, e não um isolamento puro do efeito de formatação.
A diferença bruta era grande. O efeito causal, não
Aqui é onde a coisa fica interessante. Quando os pesquisadores moveram a mesma página para cima dentro do seu par, a chance de ela ser citada subiu 7,9 pontos percentuais, um resultado que perdeu a significância estatística depois do ajuste para múltiplos testes. Em outro conjunto, com 56 pares em que apenas a ordem foi trocada, a estimativa foi de 0,0 ponto, com intervalo de confiança de 95% indo de menos 5,4 a mais 5,4.
| Medida | Resultado | Leitura |
|---|---|---|
| Diferença bruta entre 1ª e 5ª posição | 42,3 pontos percentuais | Mistura posição com qualidade da página |
| Troca controlada de ordem (113 pares) | Mais 7,9 pontos, sem significância | Efeito muito menor do que o bruto sugeria |
| Troca controlada de ordem (56 pares) | 0,0 ponto, IC 95% de menos 5,4 a mais 5,4 | Nenhum efeito detectável |
| Reescrita estruturada, marcadores por resposta | Mais 0,50 marcador, IC 95% de 0,20 a 0,84 | Redistribui crédito, não amplia o total |
| Reescrita estruturada, chance de ser citado | Mais 4,5 pontos, IC 95% de menos 1,4 a mais 10,4 | Inconclusivo |
A explicação dos autores é direta. Provedores de busca costumam colocar as páginas mais relevantes no topo, então a diferença bruta reflete posição e qualidade ao mesmo tempo. Separar as duas coisas exige trocar a ordem mantendo o par equivalente. Vale notar que aqui posição significa a ordem dos cinco resultados da Exa numa chamada de busca, e não a colocação no Google.
Estruturar o texto concentra crédito, mas não abre a porta
Páginas reescritas com títulos e listas receberam, em média, 0,50 marcador de citação a mais por resposta em comparação com as mesmas páginas em parágrafos corridos. O intervalo de confiança de 95% vai de 0,20 a 0,84, então o efeito existe. As respostas do teste eram bastante citadas, com mediana de 29 marcadores distribuídos entre seis documentos.
O detalhe que muda a interpretação: o total de citações por resposta não subiu, e o número na outra página quase não se mexeu. Ou seja, o crédito foi realocado, não criado. E o teste principal, aquele que os pesquisadores planejaram antes de começar o experimento, era outro: a página chega a ser citada? Aí o ganho foi de 4,5 pontos percentuais, com intervalo de menos 1,4 a mais 10,4. Inconclusivo, num estudo que só conseguia detectar com segurança efeitos de cerca de 8,5 pontos para cima.
Este é um alerta de sensibilidade de atribuição, não uma tática de otimização.
Sriram Selvam e Anneswa Ghosh, na seção de discussão do estudo CITECHOICE
Uma resposta só não prova nada
A parte mais desconfortável do estudo para quem vende monitoramento de citações está aqui. Os pesquisadores rodaram 120 respostas de novo, com os mesmos insumos. Em 15% dos casos, um em cada sete, a decisão de citar ou não a página alvo mudou. Eles estimam que cerca de 45% da variação medida numa rodada única vem da aleatoriedade do modelo.
Isso conversa com um dado que a SparkToro publicou em janeiro sobre a inconsistência das ferramentas de IA ao recomendar marcas: ChatGPT e AI Overviews produziram a mesma lista em menos de 1% das vezes diante do mesmo prompt repetido. E conversa com um relatório da Ahrefs de maio, que mostrou que páginas citadas por IA tinham cerca de três vezes mais chance de conter schema em JSON-LD, sem que adicionar schema aumentasse as citações de forma clara, como reuniu o Search Engine Journal ao analisar o estudo.
O padrão se repete: correlação forte no relatório do fornecedor, efeito frágil quando alguém mexe na variável. É o mesmo cuidado que já aplicamos ao analisar o estudo sobre citações concentradas no primeiro terço do conteúdo e ao mapear o que 131 especialistas dizem sobre ranqueamento.
O que muda no seu trabalho de GEO
- Pare de comemorar ou lamentar uma resposta isolada. Se uma em cada sete rodadas muda o resultado com o mesmo insumo, declarar vitória ou derrota com base numa consulta é ruído, não medição.
- Rode o mesmo teste várias vezes e reporte a variação. Um relatório maduro mostra a dispersão entre rodadas, não só a média.
- Desconfie de correlação de fornecedor. A pergunta é simples: alguém testou isso mexendo na variável, ou só observou o que já estava lá?
- Estruture o conteúdo, mas pelo motivo certo. Títulos, listas e tabelas valem pela clareza. O que o estudo não sustenta é a promessa de que abrem a porta da citação.
- Separe entrar da fatia. Ser citado e receber mais marcadores são coisas diferentes. A reescrita mexeu na segunda, não comprovadamente na primeira.
Os limites que o próprio estudo reconhece
Nada disso significa que formatação e posição sejam irrelevantes na vida real. O teste cobriu um único agente de busca, com um único provedor, em conversas reproduzidas offline e sem edição em páginas ao vivo. As reescritas se aplicaram apenas a texto já recuperado, o que deixa de fora rastreamento, recuperação e ranqueamento, justamente as etapas que decidem se a sua página entra na lista de candidatas.
Os autores reproduziram as buscas salvas no Grok 4.3 e as reescritas estruturadas penderam na mesma direção. A recomendação final deles é ampliar o escopo: testar cada cenário algumas vezes, variar provedores e modelos, e olhar tanto a frequência das citações quanto a chance de a página ser citada.
Para quem trabalha com GEO, a mensagem prática é menos empolgante e mais útil do que a promessa de um truque de formatação. Aparecer nas respostas continua passando por ser relevante, recuperável e confiável o suficiente para entrar na lista. O que acontece depois disso é mais instável do que os relatórios costumam admitir.
Perguntas frequentes
A ordem das fontes influencia a citação em busca com IA?
Menos do que os números brutos sugerem. A diferença observada entre primeira e quinta posição foi de 42,3 pontos percentuais, mas ao trocar a ordem de páginas equivalentes o efeito caiu para 7,9 pontos sem significância estatística, e chegou a 0,0 ponto num conjunto de 56 pares.
Vale a pena reescrever conteúdo com títulos e listas para ser mais citado?
O estudo mostrou que a reescrita estruturada concentra mais marcadores de citação na página, cerca de 0,50 a mais por resposta, mas sem aumentar o total de citações nem comprovar aumento na chance de ser citado. Estruture pela clareza, não pela promessa de citação.
Por que a mesma pergunta gera citações diferentes?
Por aleatoriedade do modelo. Ao repetir 120 respostas com insumos idênticos, a decisão de citar ou não mudou em 15% dos casos. Os autores estimam que cerca de 45% da variação de uma rodada única vem dessa instabilidade.
O estudo já foi revisado por pares?
Não. É um preprint publicado no arXiv em 14 de setembro de 2026. Os resultados são relevantes, mas devem ser lidos com a cautela que um trabalho ainda não revisado exige.
Então monitorar citações em IA não serve para nada?
Serve, desde que a metodologia acompanhe a instabilidade do meio. Isso significa repetir cada consulta várias vezes, reportar a variação entre rodadas e evitar conclusões baseadas numa única resposta.