
Em 28 de setembro, a Anthropic lançou o Claude Sonnet 5.5, novo modelo intermediário da família. A empresa o posiciona como um parceiro de trabalho mais rápido e mais barato, segundo o TechCrunch. Para quem usa IA em marketing, atendimento e análise de dados, a pergunta prática é simples: vale trocar de modelo?
Reunimos os números oficiais, o que medições independentes mostram e como decidir com base em custo por tarefa, e não só em preço por token.
O que muda no Sonnet 5.5
O preço da API permanece em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, o mesmo do Sonnet 5, como confirma a página oficial do Claude Sonnet 5.5. A economia vem da eficiência: a Anthropic afirma que o modelo roda mais de 30% mais rápido e custa até 30% menos por tarefa que o antecessor, porque usa menos tokens e faz menos chamadas de ferramentas.
O Sonnet 5.5 é o primeiro modelo Sonnet que estará sujeito às mesmas salvaguardas de cibersegurança que valem para o Fable e o Opus.
Anthropic, conforme reportado pelo TechCrunch
Essa é outra mudança relevante: é o primeiro Sonnet com as proteções de cibersegurança dos modelos de topo, e o primeiro desse nível com classificadores contra ataques de destilação, segundo o The Decoder. O modelo está disponível na AWS, no Google Cloud e no Microsoft Azure, com o identificador claude-sonnet-5-5. A Anthropic também avisou que uma nova versão do Haiku chega nas próximas semanas, sem data firme.
O que dizem os benchmarks
A tabela abaixo reúne os resultados divulgados pela própria Anthropic. Ela ajuda a ver onde o modelo intermediário já encosta no topo da família e onde ainda fica atrás.
| Benchmark | Sonnet 5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 (código no terminal) | 10,3% | 70,6% | 66,4% |
| CursorBench 4.0 (edição de código) | 34,1% | 55,5% | 57,8% |
| GDPval-AA v2.1 (trabalho de conhecimento, Elo) | 1.449 | 1.844 | 1.846 |
| AA-Briefcase v1.1 (Elo) | 1.359 | 1.811 | 1.822 |
| Humanity’s Last Exam | 54,9% | 64,5% | 67,7% |
| OSWorld 2.1 (uso de computador) | 57,0% | 80,1% | 81,8% |
| Chartography (leitura de gráficos) | 15,6% | 61,6% | 64,4% |
Dois pontos chamam atenção. Em trabalho de conhecimento, o Sonnet 5.5 marca 1.844 pontos no GDPval-AA contra 1.846 do Opus 5.5, ou seja, praticamente empata com o modelo maior em tarefas do dia a dia. E em código no terminal ele até supera o Opus, o que é raro em um modelo intermediário.
Como esses números são da fabricante, vale cruzar com medição independente. A Artificial Analysis colocou o Sonnet 5.5 em segundo lugar no seu índice de inteligência, com 56 pontos, contra 58 do Opus 5.5 e 38 do Sonnet 5. Na medição deles, o Terminal-Bench ficou em 64% para o Sonnet 5.5 e 60% para o Opus 5.5, números diferentes dos oficiais, mas com a mesma conclusão de ordem. A mesma análise traz um alerta útil: em esforço máximo, o modelo gera muito mais tokens de saída que os concorrentes, o que pode comer parte da economia se você não controlar o nível de esforço.
Preço: onde está a diferença real
| Item (por 1 milhão de tokens) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Entrada | US$ 2 | US$ 4 |
| Saída | US$ 10 | US$ 20 |
| Gravação de cache | US$ 2,50 | US$ 5 |
| Leitura de cache | US$ 0,20 | US$ 0,20 |
Na prática, o Sonnet 5.5 custa metade do Opus 5.5 por token e entrega desempenho próximo na maioria das tarefas de rotina. É por isso que a decisão deve olhar o custo por tarefa concluída, e não a tabela de preços isolada.
Resultados relatados por clientes
O VentureBeat reúne números de empresas que testaram o modelo. A Box relatou que ele foi 2,4 vezes mais rápido e usou 12% menos tokens no total. A Lovable observou cerca de um terço menos chamadas de ferramentas em tarefas de código. São relatos de parceiros, feitos em cenários próprios, e devem ser lidos como indicativos, não como garantia para o seu caso.
Onde o Sonnet 5.5 se encaixa
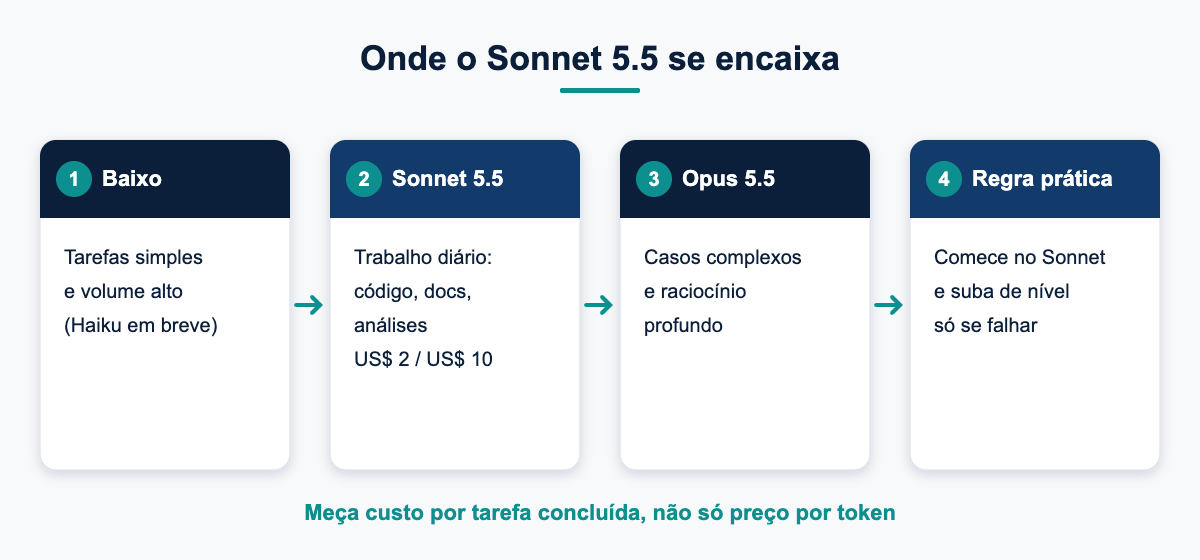
Nossa leitura, com base nos dados acima, é usar o Sonnet 5.5 como ponto de partida para tarefas bem definidas e recorrentes, como redação de rascunhos, análise de planilhas, classificação de leads e agentes de atendimento. O Opus 5.5 fica para casos complexos, de raciocínio profundo, e o Haiku, quando chegar, para volume alto e tarefas simples.
Como testar sem se enganar
- Defina uma amostra real: use de 30 a 50 tarefas do seu fluxo, como e-mails, relatórios ou tickets.
- Meça custo por tarefa concluída: some tokens, chamadas de ferramentas, tempo e retrabalho humano.
- Controle o nível de esforço: a documentação oficial de prompting do Claude Opus 5.5, citada pelo Search Engine Journal, recomenda retestar as configurações de esforço em vez de reaproveitar as do modelo anterior. Isso pesa ainda mais aqui, dado o volume de tokens de saída em esforço máximo.
- Valide a segurança: se o modelo atende clientes, revise acesso a dados e limites de ação, tema que tratamos em agentes de IA fora de controle.
O impacto no orçamento de IA
Modelos mais eficientes reduzem o custo unitário, mas o gasto total costuma crescer com o uso. O dado do gasto global com IA em 2026 segundo o Gartner mostra a escala do investimento. Por isso, acompanhe o custo por resultado de negócio, como lead qualificado ou ticket resolvido, e ajuste o modelo por caso de uso. Em vendas online, isso conversa com a disputa por agentes de compra, como no caso do Muse da Meta bloqueado pela Amazon.
Perguntas frequentes
Quanto custa o Claude Sonnet 5.5?
O preço da API é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, o mesmo do Sonnet 5 e metade do Opus 5.5. A economia extra vem do menor consumo de tokens e do menor número de chamadas de ferramentas.
O Sonnet 5.5 é melhor que o Opus 5.5?
Não em tudo. Ele empata na prática em trabalho de conhecimento (1.844 contra 1.846 no GDPval-AA) e supera o Opus no Terminal-Bench 4.0, mas fica atrás em edição de código, raciocínio e uso de computador.
Onde posso usar o Sonnet 5.5?
Ele está disponível na plataforma da Anthropic, na AWS, no Google Cloud e no Microsoft Azure, com o identificador claude-sonnet-5-5.
Vale migrar do Sonnet 5 para o 5.5?
Provavelmente, já que o preço é igual e o salto nos benchmarks é grande. Mesmo assim, teste com tarefas reais, ajuste prompts e controle o nível de esforço antes de migrar tudo.
Os benchmarks são confiáveis?
São o melhor ponto de partida, mas a maior parte vem da própria Anthropic. A medição independente da Artificial Analysis aponta a mesma ordem, com valores diferentes. Trate os números como referência e confirme no seu fluxo.