
Poucos status do Search Console geram tanta ansiedade quanto “Rastreada, mas não indexada”. A página existe, o Google a visitou e, mesmo assim, decidiu não colocá-la no índice. O primeiro impulso é pedir a indexação de novo, e de novo. Não resolve, e a própria documentação do Google avisa que não é preciso reenviar.
Este guia explica o que o status significa, como ele difere de “Descoberta, mas não indexada”, como diagnosticar a causa por tipo de página e o que corrigir em cada caso, com foco em lojas virtuais. Há uma limitação que vale declarar logo: o Google não publica a lista de causas desse status nem um prazo de reindexação. Quando algo aqui é inferência ou método da Analytikos, o texto diz.
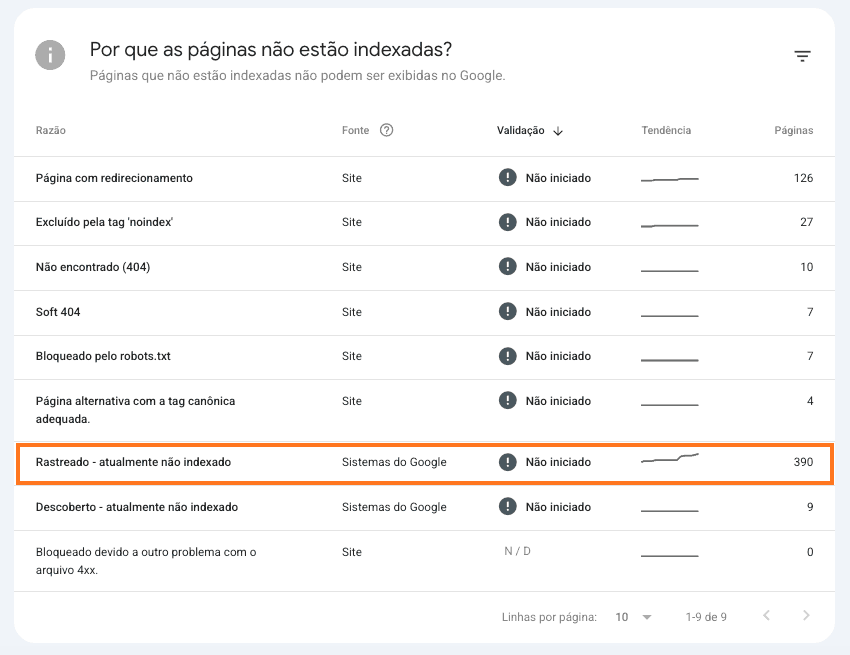
O que significa “Rastreada, mas não indexada”
Na ajuda do relatório de indexação de páginas, o Google define o status assim: a página foi rastreada, mas não indexada. A mesma página diz que ela pode ou não ser indexada no futuro e que não há necessidade de reenviar a URL para rastreamento.
Traduzindo: o Googlebot buscou a página, avaliou o que encontrou e não a incluiu no índice naquele momento. É uma decisão sobre indexação, não um problema para acessar a página. Em muitas lojas, parte desse volume é saudável, porque algumas URLs não deveriam mesmo estar no índice (filtros, busca interna, duplicatas).
Rastreada x descoberta: a diferença que muda o diagnóstico
Os dois status parecem parecidos e têm causas distintas. Confundi-los leva a corrigir a coisa errada.
| Critério | Rastreada, mas não indexada | Descoberta, mas não indexada |
|---|---|---|
| O que o Google diz | A página foi rastreada, mas não indexada | A página foi encontrada, mas ainda não rastreada |
| Onde está o gargalo | Decisão de indexação | Rastreamento e prioridade |
| Causa descrita pelo Google | Não detalha | O rastreamento foi reagendado porque o Google esperava sobrecarregar o site |
| Causas prováveis (inferência) | Conteúdo sem valor adicional, duplicação, soft 404, página sem links internos | Volume enorme de URLs inúteis, servidor lento, baixa demanda percebida |
| Foco da correção | Qualidade, canonical, links, HTTP correto | Reduzir URLs inúteis, melhorar o servidor, reforçar links internos |
O guia de orçamento de rastreamento explica que o rastreamento combina a capacidade do servidor e a demanda do Google, e que a demanda depende de tamanho, frequência de atualização, qualidade e relevância. O mesmo guia é direcionado a sites com grande parcela de URLs em “Descoberta, mas não indexada”. Para lojas pequenas, o status que mais aparece é o “Rastreada”.
Por que o Google rastreia e decide não indexar
O Google não publica uma lista de causas para esse status. O que há são critérios de qualidade e regras de duplicação que, combinados, explicam a maior parte dos casos. A ligação entre eles e o status é uma inferência razoável, não uma declaração oficial.
Conteúdo sem valor adicional
A página de conteúdo útil sugere perguntas de autoavaliação: o texto traz valor substancial em relação a outras páginas nos resultados? Há informação original? Ou apenas resume o que outros dizem? No e-commerce, os casos típicos são a ficha com a descrição copiada do fabricante, a categoria com dois produtos e a tag sem conteúdo.
Duplicação e conflito de canonical
Segundo o guia de consolidação de URLs duplicadas, o Google agrupa páginas parecidas e escolhe uma canônica. Redirecionamento e rel=canonical são sinais fortes; o sitemap é um sinal fraco. Conflitos entre eles (por exemplo, sitemap com uma URL e canonical apontando para outra) confundem a escolha. Veja também os desfechos da canonical entre domínios.
Soft 404
É a página que mostra “produto indisponível” ou “nenhum resultado” mas devolve código HTTP 200. O Google trata como soft 404, e o guia de orçamento de rastreamento diz que elas continuam sendo rastreadas e desperdiçam orçamento.
Filtros, parâmetros e busca interna
A documentação de navegação facetada descreve que os rastreadores acessam um número muito grande de URLs de filtros antes de perceber que não têm valor, e isso consome tempo que iria para URLs novas e úteis.
Falta de links internos e renderização por JavaScript
Segundo a documentação de links rastreáveis, toda página que você quer indexada deve ter pelo menos um link de outra página do site, no formato a href. Elementos com onclick não são confiáveis. Em sites que dependem de JavaScript, o Google rastreia, renderiza e só depois indexa, como descreve o guia de JavaScript SEO. Um noindex no HTML original pode impedir a renderização.
Diagnóstico em cinco passos
Os passos 1 e 2 usam recursos documentados do Search Console. A amostragem por tipo de página (passo 3) é método recomendado pela Analytikos, não procedimento do Google.
Fluxo de diagnóstico, do relatório à causa
Imagem: Analytikos
Exemplo numérico (hipotético)
Uma loja fictícia tem 12.000 URLs no sitemap. Dessas, 3.000 aparecem como “Rastreada, mas não indexada”, ou 3.000 ÷ 12.000 = 25%. Por tipo de página: 600 de 8.000 produtos (7,5%), 30 de 300 categorias (10%) e 2.370 de 3.700 URLs de filtros (64%). A soma bate: 600 + 30 + 2.370 = 3.000.
O problema não está espalhado: 2.370 ÷ 3.000 = 79% dele está nos filtros. A ação é tirar os filtros do sitemap e bloquear parâmetros sem demanda de busca. O sitemap passa a ter 12.000 − 3.700 = 8.300 URLs, e as 630 não indexadas restantes (600 + 30) equivalem a 7,6%. O indicador caiu de 25% para 7,6% sem indexar nada novo, porque o denominador passou a refletir só o que importa.
Páginas não indexadas por tipo, em % do tipo (exemplo hipotético)
Gráfico: Analytikos, com números hipotéticos
Plano de correção por causa
| Causa | O que fazer | Como verificar |
|---|---|---|
| Conteúdo fino ou copiado | Descrição própria (uso, medidas, compatibilidade, perguntas reais), unir variações e podar categorias vazias | Taxa de indexação do tipo de página nas semanas seguintes |
| Duplicados e canonical conflitante | Alinhar canonical, sitemap e links internos para a mesma URL; redirecionar duplicatas reais | Inspeção de URL: canônica declarada igual à escolhida |
| Soft 404 | Devolver 404 ou 410 para o que não volta; 301 para equivalente real | Teste ao vivo: código HTTP correto |
| Filtros e parâmetros | Bloquear parâmetros sem demanda no robots.txt e manter canonical nas listagens; indexar só facetas com demanda e URL limpa | Queda de URLs de filtro no relatório |
| Falta de links internos | Ligar a partir de categorias, home e conteúdo relacionado, com âncora descritiva | Profundidade de cliques e link no HTML renderizado |
| JavaScript | Colocar conteúdo e links no HTML renderizado; sem noindex no HTML inicial | HTML renderizado na inspeção de URL |
| Sitemap sujo | Incluir só URLs canônicas, indexáveis e com lastmod fiel | Contagem de URLs enviadas x indexadas |
Para páginas de produto e categorias, os guias SEO para página de produto e auditoria de SEO ajudam a priorizar. Para quem acabou de migrar, o checklist de migração cobre redirecionamentos e sitemap.
O que não fazer
- Reenviar a mesma URL dezenas de vezes. A ajuda da Inspeção de URL diz que a solicitação entra numa fila, não garante a indexação e tem limite diário.
- Usar a Indexing API. A documentação limita o uso a páginas com JobPosting ou BroadcastEvent em VideoObject. Não serve para produto ou blog.
- Bloquear no robots.txt para “resolver” duplicatas. O Google pode indexar uma URL bloqueada sem conteúdo.
- Usar noindex para escolher a canônica. O guia de duplicatas recomenda outros sinais.
- Inflar o sitemap. O Google diz que o sitemap não garante que todos os itens serão rastreados e indexados.
- Tentar indexar tudo. Filtros, busca interna e duplicatas não precisam estar no índice.
Quanto tempo esperar depois de corrigir
Não existe prazo oficial de reindexação. O único número da documentação é que, depois de conhecer a URL, o rastreamento pode levar até algumas semanas. Trate o prazo como orientação prática: monitore uma amostra de URLs em ciclos de semanas, corrija em lotes por tipo de página e compare a taxa de indexação antes e depois. Veja também o que o Google já disse sobre tempos em rastreamento, indexação e recuperação.
Exemplo numérico de ficha duplicada (hipotético)
Uma loja tem 500 fichas de um fornecedor com a mesma descrição de fábrica, e 320 estão não indexadas (320 ÷ 500 = 64%). Com redação própria em 40 fichas por semana, a cobertura leva 320 ÷ 40 = 8 semanas, começando pelas mais vendidas. Se 70% de um lote de 40 for indexado depois da reescrita (suposição do exercício, não benchmark), a projeção é 320 × 0,70 = 224 fichas indexadas.
Erros comuns ao tratar páginas rastreadas e não indexadas
Erros de interpretação
| Erro | Por que distorce | Como corrigir |
|---|---|---|
| Tratar todo o volume do status como problema | Parte das URLs não deveria ser indexada; o status inflado esconde o que importa | Classificar por tipo de página e decidir o que deve estar no índice |
| Confundir rastreada com descoberta | As correções são diferentes (qualidade x rastreamento) | Ler a definição de cada status antes de agir |
| Achar que o status é penalidade | O Google diz que a página pode ser indexada no futuro; não é ação manual | Verificar o relatório de ações manuais separadamente |
| Atribuir tudo a “orçamento de rastreamento” | O guia é voltado a sites grandes; em lojas pequenas o problema costuma ser qualidade | Investigar conteúdo e duplicação primeiro |
Erros de ação
| Erro | Por que distorce | Como corrigir |
|---|---|---|
| Reenviar a URL repetidamente | Não garante indexação e consome cota diária | Corrigir a causa e esperar o ciclo |
| Mudar só o texto sem tratar canonical ou HTTP | A causa real continua | Verificar canonical, status HTTP e noindex antes de reescrever |
| Colocar noindex ou bloquear tudo de uma vez | Pode remover páginas que trazem receita | Agir por lote, começando pelos tipos de página sem tráfego |
| Inflar o sitemap com URLs fracas | Reduz o sinal de prioridade do que importa | Manter só URLs canônicas e indexáveis |
| Podar sem consolidar | Perde links internos e sinal histórico | Redirecionar a página removida para a equivalente mais próxima |
Erros de medição
| Erro | Por que distorce | Como corrigir |
|---|---|---|
| Olhar o relatório inteiro, sem o sitemap como filtro | Mistura URLs úteis e lixo de parâmetros | Filtrar por sitemap e por tipo de página |
| Comparar semanas diferentes de sazonalidade | O ritmo de rastreamento muda com o calendário | Comparar com o período anterior de mesma natureza |
| Medir só indexação, sem tráfego | Indexar não é ranquear | Cruzar com cliques e impressões do relatório de desempenho |
Checklist rápido
- Separei o relatório por sitemap e por tipo de página.
- Inspecionei uma amostra por tipo e comparei canônica declarada x escolhida.
- Conferi código HTTP, noindex e links a href no HTML renderizado.
- Tirei do sitemap tudo que não deve ser indexado.
- Tratei duplicados e soft 404 antes de reescrever conteúdo.
- Fiz ajustes por lote e deixei um intervalo de semanas entre as medições.
- Registrei o que é recomendação nossa e o que é regra do Google.
Perguntas frequentes
“Rastreada, mas não indexada” é uma penalidade?
Não. É um status do relatório de indexação. O Google diz que a página pode ou não ser indexada no futuro. Ações manuais aparecem em um relatório separado.
Devo reenviar a URL para indexação várias vezes?
Não. A ajuda do Search Console diz que não há necessidade de reenviar, e a solicitação não garante a indexação, além de ter limite diário.
Qual a diferença para “Descoberta, mas não indexada”?
Na descoberta, o Google conhece a URL mas ainda não a rastreou. Na rastreada, ele já viu a página e decidiu não indexar. A primeira é um gargalo de rastreamento; a segunda, de decisão de indexação.
Quanto tempo leva para a página ser indexada depois da correção?
Não há prazo oficial. O Google cita que o rastreamento de URLs conhecidas pode levar até algumas semanas. Monitore uma amostra em ciclos de semanas.
Conteúdo fino sempre causa esse status?
O Google não afirma essa ligação. É uma inferência razoável a partir dos critérios de conteúdo útil, e deve ser tratada como hipótese a testar.
Posso usar a Indexing API para acelerar?
Não para lojas e blogs. A API é limitada a páginas com JobPosting ou BroadcastEvent em VideoObject.