
Quando alguém pergunta a um assistente de IA qual tênis de corrida comprar, a resposta não nasce de uma descrição bonita. Ela nasce de dados: identificadores, atributos, preço, estoque, frete, devolução e avaliações. Quem tem esses campos completos e coerentes entre feed, página e marcação tem mais para casar com a pergunta. Quem escreve só “confortável, leve e moderno” entrega pouco material para a máquina trabalhar.
Nenhuma plataforma publica o critério de ranking dos produtos que recomenda. Por isso, este guia separa com cuidado o que a documentação oficial afirma do que é inferência. O que se sabe é onde cada plataforma recebe os dados e quais campos ela documenta. O resto é boa prática de catálogo, que ajuda no Google Shopping, no feed do ChatGPT e em qualquer canal que leia dados estruturados.
A seguir, como os assistentes recebem dados de produto, quais atributos cadastrar e onde, um modelo de descrição para humano e máquina, uma fórmula de completude, o passo a passo de auditoria e os erros mais comuns.
Como os assistentes recebem dados de produto
Google: feed do Merchant Center e dados estruturados
As páginas de ajuda do Merchant Center sobre destaques do produto (product_highlight) e detalhes do produto (product_detail) dizem que enviá-los ajuda o cliente a encontrar o produto em superfícies de IA, como o Modo IA. O Google também documenta atributos conversacionais, todos opcionais: perguntas e respostas (question_and_answer), link de documento (document_link), produto relacionado (related_product), título do grupo de itens (item_group_title), opção de variante (variant_option) e ranking de popularidade (popularity_rank). A página afirma que eles não afetam a aprovação dos produtos existentes.
Na página sobre recursos de IA e o seu site, o Google diz que não há marcação schema.org especial nem otimização adicional para aparecer nos AI Overviews ou no Modo IA, e recomenda que os dados estruturados reflitam o texto visível da página. Como inferência, o feed do Merchant Center é o canal mais direto no Google, e o schema na página funciona como checagem cruzada. Para o dia a dia da loja, veja o guia de listagens gratuitas no Google Shopping e o de Modo IA do Google.
ChatGPT: feed de produtos no protocolo de comércio
Segundo a OpenAI, comerciantes compartilham feeds de produtos pelo Agentic Commerce Protocol, direto ou por provedores. A especificação do feed de produtos exige 11 campos: item_id, title, description, url, brand, seller_name, image_url, availability, price, target_countries e store_country. São opcionais, entre outros, gtin, mpn, material, color, size, gender, age_group, dimensões, peso, shipping, accepts_returns, return_deadline_in_days, review_count e star_rating. A especificação não descreve método de ranking, mas diz que a qualidade do feed melhora a relevância da descoberta.
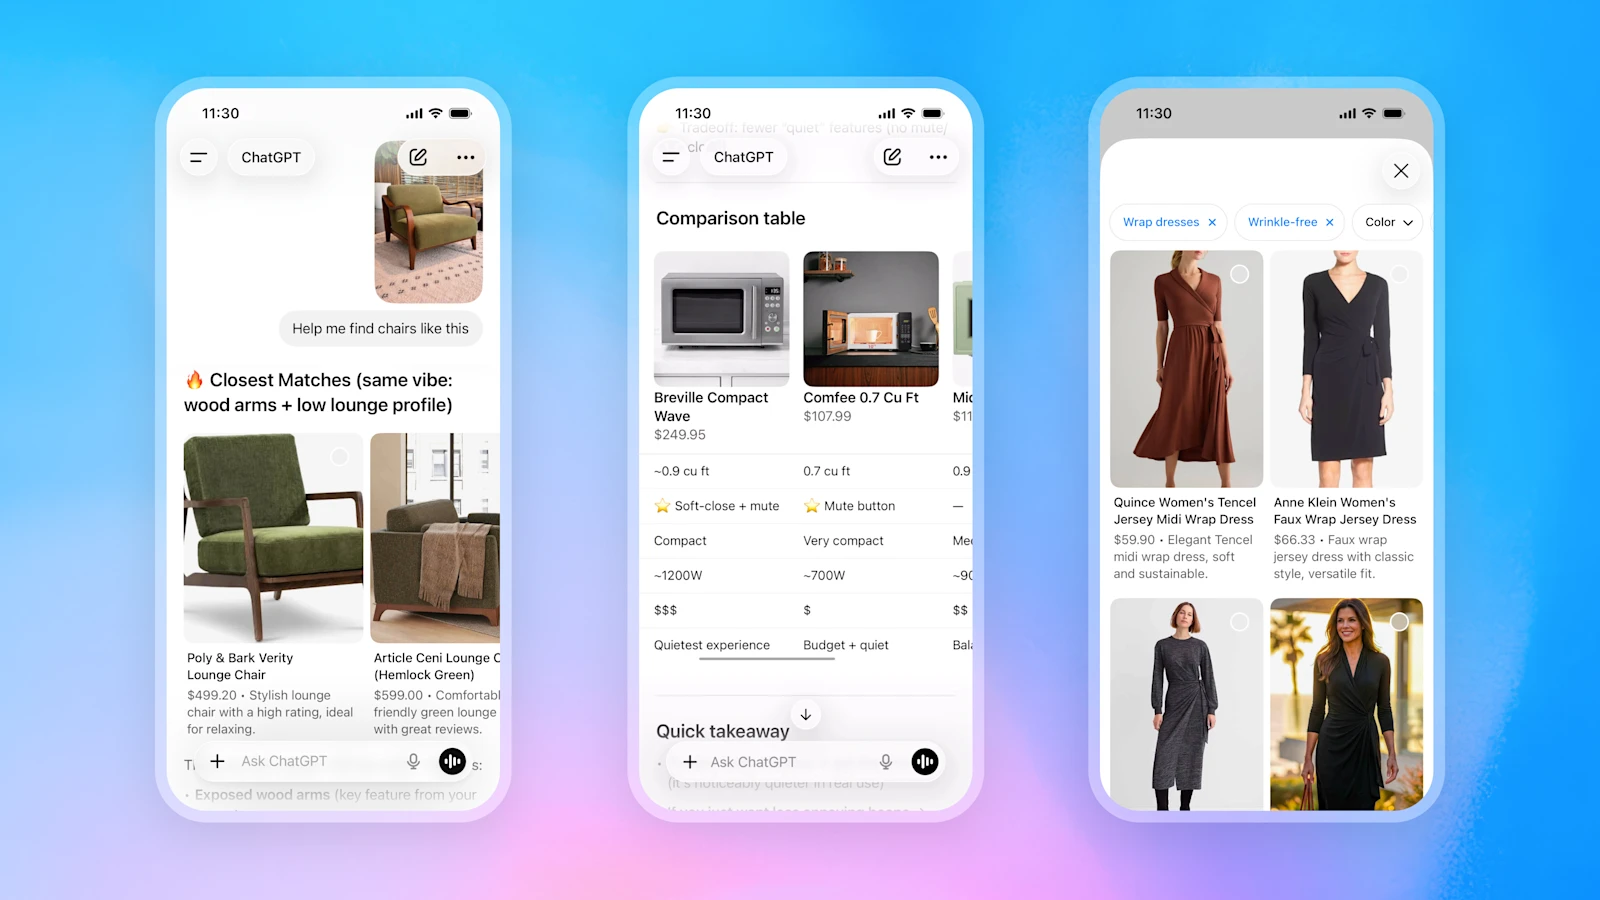
O anúncio da OpenAI traz exemplos de como esses dados aparecem para o comprador: recomendações que combinam com um item da foto, uma tabela comparativa com especificações e preços, e uma grade de produtos filtrada por atributos. A tabela do meio só existe quando o feed tem os atributos para comparar. As telas estão em inglês.
No mesmo anúncio, a OpenAI publicou um vídeo curto de demonstração da experiência de compras no ChatGPT, também com a interface em inglês.
Outras plataformas e a situação no Brasil
A Perplexity afirma que os cartões de produto não são patrocinados e que varejistas podem enviar especificações pelo programa para comerciantes. A Microsoft Advertising diz que a maioria dos feeds foi feita para anúncios e traz só parte do catálogo, e que a IA precisa do catálogo completo e estruturado. Em nenhum caso há ranking documentado. Quanto ao Brasil, não foi encontrada documentação oficial que confirme a disponibilidade de compras no ChatGPT, no Copilot ou no Modo IA para lojistas brasileiros: confirme antes de planejar investimento específico em um canal.
O diagrama resume os três caminhos pelos quais os dados de um mesmo cadastro chegam aos assistentes. A base é única: se o cadastro estiver incompleto, a lacuna se repete em todos os canais.
Do cadastro ao assistente
Um cadastro, vários canais de leitura
Cadastro do produto na loja
título, descrição, atributos, GTIN, preço, estoque, frete e devolução↓
Feed do Merchant Center (destaques, detalhes, atributos conversacionais) e dados estruturados na página
Pesquisa, Shopping e Modo IA
Feed de produtos no Agentic Commerce Protocol, direto ou por provedores
Compras no ChatGPT
Programas para comerciantes e feeds de catálogo
Perplexity e Copilot
Atributos por tipo e onde cadastrar cada um
A tabela organiza os atributos em cinco grupos e indica onde cada um vive: no feed, no schema JSON-LD ou no texto visível da página. A classificação por grupo é editorial; as obrigações vêm da documentação de cada plataforma.
| Grupo | Atributos | Onde cadastrar | Observação |
|---|---|---|---|
| Identidade | Título, marca, GTIN, MPN, grupo de variantes | Feed, schema e H1 | Marca é obrigatória no Google (produtos novos, exceto livros, filmes e música) e no feed da OpenAI. GTIN é fortemente recomendado no Google; MPN é exigido se não houver GTIN |
| Descrição | Descrição, destaques, detalhes, perguntas e respostas | Feed, schema e texto da página | OpenAI aceita descrição de até 5.000 caracteres; destaques do Google têm 4 a 6 itens recomendados, com foco em benefício |
| Decisão | Cor, tamanho, material, gênero, faixa etária, dimensões, peso, medidas técnicas | Feed e página; schema para cor, material e tamanho | Cor, gênero e faixa etária são obrigatórios no Google em vestuário no Brasil e em outros países |
| Preço e logística | Preço, estoque, frete, devolução | Feed (configurações da conta) e schema | Nas regras do Google, configurações da conta prevalecem sobre a marcação por produto |
| Prova social | Nota média, número de avaliações, ranking de popularidade | Feed e schema (aggregateRating, review) | As avaliações devem ser do produto, não da loja |
Para o schema em si, o guia de dados estruturados de listagem de produto do Google descreve as propriedades de Product e Offer, e o guia de dados estruturados de produto detalha preço, disponibilidade e avaliações. Para devolução e frete, o Google documenta uma ordem de precedência em que as configurações do Merchant Center ou do Search Console prevalecem sobre a marcação.
Modelo de descrição para humano e para máquina
A descrição eficaz tem uma estrutura repetível. Os dados duros vão para o feed e o schema, e a narrativa fica na página:
- Primeira frase: o que é, para quem e para qual uso, com marca, modelo e o atributo-chave.
- Benefícios: 4 a 6 linhas curtas (viram os destaques do produto).
- Especificações: tabela com medidas e materiais (vira o detalhe do produto).
- Para quem serve e para quem não serve: reduz devolução e ajuda a IA a casar a pergunta.
- Perguntas reais: dúvidas frequentes dos clientes (viram pergunta e resposta).
- Frete e devolução do item: uma linha, igual ao que está no feed.
Exemplo antes e depois (produto hipotético)
| Versão | Texto e cadastro |
|---|---|
| Antes | “Tênis Fast Pro. Confortável, leve e moderno. Ideal para o seu dia a dia. Compre já!” Sem GTIN, sem cor padronizada, sem peso, sem drop. |
| Depois | “Tênis de corrida Aurora Fast 3, masculino, para treinos de 5 a 21 km em asfalto. Pisada neutra, amortecimento médio, drop de 8 mm, peso de 265 g (tamanho 42). Cabedal em malha respirável, solado em borracha. Cores: preto e laranja. Tamanhos: 38 a 46.” Destaques e detalhes preenchidos; GTIN válido, MPN, marca, gênero, faixa etária, cor, material e tamanho cadastrados. |
Na versão “depois”, cada afirmação é verificável e cada atributo tem um campo próprio. Um assistente que responda “tênis neutro para treino longo, até R$ 600” tem dados para filtrar. Na versão “antes”, não tem.
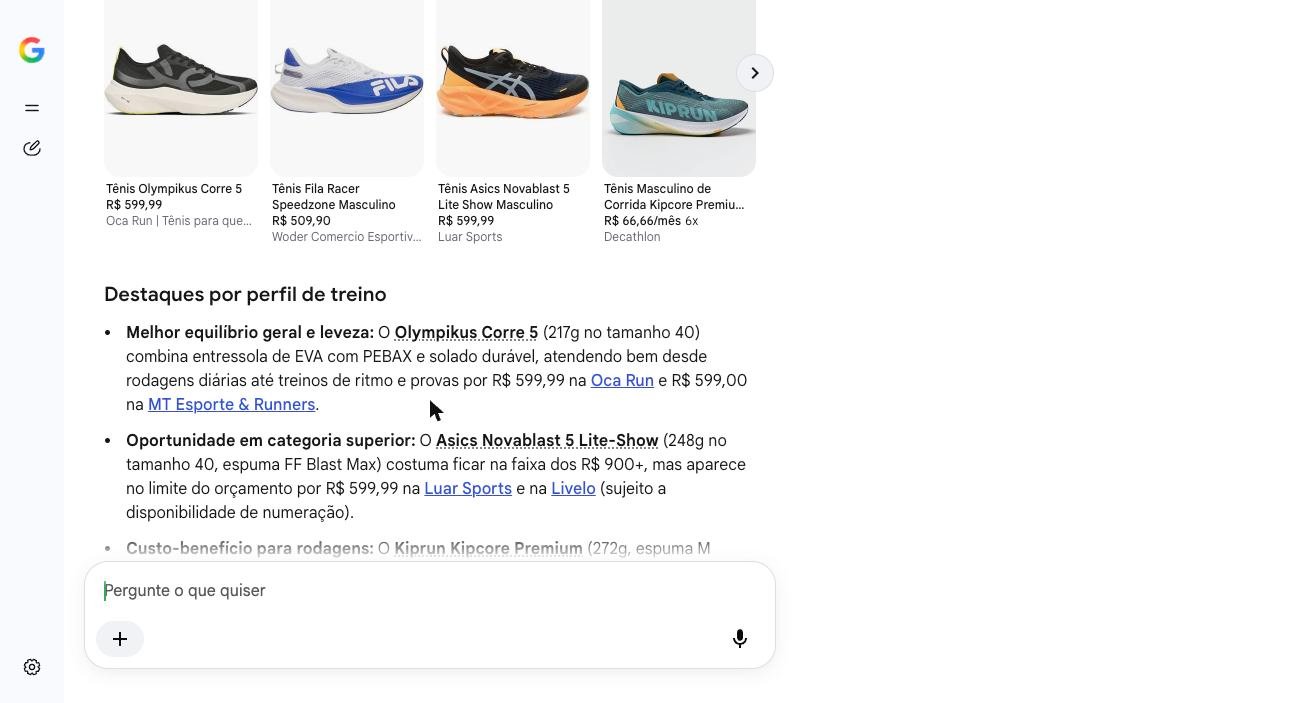
Na prática, é esse tipo de dado que a IA usa para recomendar. Numa busca no Modo IA do Google por “tênis de corrida masculino amortecimento médio drop 8mm até R$ 600”, a resposta filtrou por faixa de preço e destacou peso por numeração, tipo de espuma e preço em cada loja. Atributos que estavam no cadastro de quem foi citado.
Fórmula de completude por SKU
Para priorizar o trabalho, calcule a completude de cada produto: soma dos pesos dos atributos preenchidos e válidos, dividida pela soma dos pesos aplicáveis, vezes 100. Os pesos abaixo são sugeridos e ajustáveis: identidade 3, descrição 2, decisão 3, preço e logística 3, prova social 1.
Exemplo: um tênis com 14 atributos aplicáveis e 9 preenchidos tem 9 ÷ 14 = 64% sem pesos. Com pesos, suponha que a soma dos pesos aplicáveis seja 36 e que faltem GTIN (3), drop (3), peso (3), destaques (2) e perguntas e respostas (2), somando 13. A completude ponderada é (36 − 13) ÷ 36 = 23 ÷ 36 = 64%. Os dois métodos coincidem neste exemplo, mas a ponderação mostra que o que falta é justamente o que mais pesa na decisão.
Completude ponderada do SKU de exemplo
Uma meta razoável é passar de 85% nos SKUs que concentram o faturamento. Não há documentação oficial que garanta ganho de recomendação por completude; o que existe é o princípio de que mais dados corretos permitem mais correspondência.
Auditoria e priorização, passo a passo
Considere um catálogo hipotético de 2.000 SKUs, com 14 atributos aplicáveis cada.
- Contar células. 2.000 × 14 = 28.000. Se 17.640 estão preenchidas, a completude bruta é 63%, e faltam 10.360.
- Segmentar por faturamento. Suponha que 400 SKUs (20%) gerem 70% da receita. Eles formam a onda 1.
- Validar identificadores. Se 380 SKUs (19%) estão sem GTIN, a primeira ação é pedir ao fornecedor, que é a fonte do código. Não invente MPN para tapar a falta de GTIN.
- Checar consistência entre feed, página e schema (preço, estoque, cor, tamanho). A divergência é a falha mais provável de derrubar a confiança no dado.
- Estimar esforço. Onda 1: 400 SKUs × 15 minutos = 6.000 minutos, ou 100 horas. Nas ondas seguintes, preencha por regra (material, gênero, faixa etária por categoria) e revise 10% por amostragem.
- Priorizar por receita do SKU × lacuna de completude ÷ esforço. A ordem: bloqueadores (GTIN, marca, preço, estoque), depois atributos de decisão, depois conversacionais.
- Medir. Registre a completude inicial, as reprovações no Merchant Center e as impressões em listagens. O guia sobre reprovações no Merchant Center ajuda a ler os erros.
Erros comuns na descrição e no cadastro de produtos para IA
Os erros abaixo atingem tanto a aprovação do feed quanto a qualidade da correspondência. Estão agrupados por natureza.
Erros de identificação
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Produto sem GTIN | O GTIN é o identificador que liga o item a catálogos; sem ele, o produto tende a ser tratado como genérico | Obter com o fornecedor e validar o dígito verificador |
| GTIN com zeros à esquerda perdidos | Planilhas convertem o código em número; o dado fica inválido e pode ser reprovado | Tratar a coluna como texto |
| MPN inventado | Cria dado falso e conflito com outros catálogos | Deixar em branco quando não existir |
| Marca como “placeholder” | A especificação da OpenAI pede a marca real; o dado errado atrapalha a correspondência | Usar o nome do fabricante |
| Variantes soltas, sem grupo | Gera duplicidade e confusão de cor e tamanho | Agrupar com item_group_id |
Erros de texto e de atributo
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Descrição só de marketing, sem especificação | Não há atributo verificável para casar com a pergunta | Incluir destaques e detalhes com medidas |
| Cor “multicolor” ou código interno | O cliente e a IA não reconhecem o termo | Usar o nome de cor que o cliente reconhece |
| Preço, frete ou promoção nos destaques | A documentação do Google não permite; o campo próprio existe para isso | Usar os atributos de preço e frete |
| Descrição copiada do fabricante em todas as lojas | Gera conteúdo idêntico e nenhum diferencial | Reescrever com uso, público e perguntas reais |
Erros de consistência e de operação
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Feed diferente da página | Preço e estoque divergentes reduzem a confiança e podem causar reprovação | Gerar o feed da mesma fonte e atualizar a cada mudança de preço |
| Política de frete e devolução ausente | Perde-se um atributo de decisão importante | Configurar no Merchant Center e espelhar na página |
| Tratar a otimização como projeto único | Catálogos mudam; os dados envelhecem | Reauditar a cada coleção ou trimestre |
Checklist de produto pronto para IA
- GTIN válido, marca real e MPN quando existir.
- Título com marca, modelo e atributo-chave.
- Descrição com uso, público e especificações verificáveis.
- Destaques (4 a 6) e detalhes preenchidos.
- Cor, tamanho, material, gênero e faixa etária padronizados.
- Preço, estoque, frete e devolução iguais no feed, na página e no schema.
- Avaliações do produto, não da loja.
- Variantes agrupadas.
- Completude acima de 85% nos SKUs de maior faturamento.
Perguntas frequentes
Preciso de schema especial para aparecer na IA do Google?
Não, segundo o Google. Use o schema de produto existente, igual ao texto visível da página. O feed do Merchant Center continua sendo o canal mais direto.
O GTIN é obrigatório?
No feed da OpenAI, não. No Google, é fortemente recomendado, e o MPN passa a ser exigido quando não há GTIN.
Atributos conversacionais valem a pena?
São opcionais e, segundo o Google, não afetam a aprovação dos produtos existentes. Comece pelos SKUs de maior faturamento e meça o efeito.
Descrição longa ajuda?
A OpenAI aceita até 5.000 caracteres, mas o tamanho não é o ponto. Fatos verificáveis, por produto, importam mais que volume de texto.
Como entro no Perplexity?
Pelo programa para comerciantes ou por integrações como a de plataformas de loja. Verifique a elegibilidade para o Brasil, que não está confirmada na documentação.
Quando devo reauditar o catálogo?
A cada mudança de coleção ou, no mínimo, a cada trimestre. Preços, estoques e políticas mudam, e o dado desatualizado derruba a confiança.