
Filtros de cor, tamanho, marca e preço melhoram a compra, mas podem prejudicar o SEO da loja. Cada combinação de filtros costuma gerar uma URL, e o total de combinações cresce de forma explosiva. O resultado é um site com milhões de endereços quase idênticos, e um Google que gasta tempo neles em vez de rastrear os produtos novos.
A pergunta que toda loja precisa responder é simples: quais combinações merecem existir na busca e quais devem ficar fora? A resposta não é “bloquear tudo” nem “indexar tudo”. Depende da demanda de busca de cada combinação e da técnica usada, porque robots.txt, canonical e noindex fazem coisas diferentes e se anulam quando combinados do jeito errado.
Este guia explica o que a documentação do Google afirma, separa isso de recomendação prática, traz uma árvore de decisão, uma tabela comparativa das técnicas, um exemplo com contas e os erros que mais aparecem em auditorias.
O que é navegação facetada e por que ela cria problema
Segundo a documentação do Google sobre navegação facetada, ela permite ao visitante alterar como os itens são exibidos. A implementação mais comum usa parâmetros de URL e pode criar um espaço de URLs praticamente infinito, como em ?products=fish&color=radioactive_green&size=tiny, exemplo da própria documentação.
A ilustração abaixo mostra como poucos cliques nos filtros de uma categoria de tênis já geram várias URLs, algumas úteis e outras duplicadas ou sem demanda.
Cada clique no filtro gera uma URL
Categoria hipotética de tênis
Filtros
Cor
Preto
Branco
Tamanho
42
Preço
R$ 200 a R$ 400
Ordenar
Mais vendidos
/tenisCategoria sem filtro
/tenis?cor=pretoUm filtro com demanda
/tenis?cor=preto&tamanho=42Dois filtros
/tenis?tamanho=42&cor=pretoMesma página, outra ordem
/tenis?cor=preto&tamanho=42&preco=200-400&ordem=mais-vendidosFaixa de preço e ordenação
O Google lista três problemas: rastreamento excessivo (o rastreador não sabe se uma URL é útil sem buscá-la), descoberta mais lenta de conteúdo novo (o tempo gasto em URLs inúteis tira tempo das úteis) e custo de recursos do servidor. Em outra página, a documentação de orçamento de rastreamento reforça o ponto: o foco deve ser “conteúdo único”, não “URLs únicas”.
Há uma ressalva importante da mesma documentação. A preocupação com orçamento de rastreamento se aplica principalmente a sites com mais de 1 milhão de páginas únicas e mudanças semanais, ou 10 mil páginas ou mais com mudanças diárias, ou ainda com muitas URLs no status “Descobertas, no momento sem indexação” no Search Console. São estimativas aproximadas. Lojas menores raramente têm problema de orçamento, mas ainda podem ter duplicação e sinais divididos entre várias URLs da mesma intenção, o que é uma consequência prática a ser medida, não uma afirmação do Google.
Quanto uma faceta multiplica as URLs: exemplo com contas
Considere uma categoria hipotética com 12 filtros, cada um com 5 valores. Cada filtro tem 6 estados possíveis (5 valores mais “não aplicado”). As combinações possíveis são 612 = 2.176.782.336 URLs. Ninguém publica isso, mas um sistema sem limite pode expor boa parte.
Limitando a 3 filtros ativos e fixando a ordem dos parâmetros, as contas ficam assim: com um filtro, 12 × 5 = 60; com dois, C(12,2) × 5² = 66 × 25 = 1.650; com três, C(12,3) × 5³ = 220 × 125 = 27.500. Somando a listagem base: 60 + 1.650 + 27.500 + 1 = 29.211 URLs por categoria. Com 40 categorias, são 1.168.440 URLs.
Se a ordem dos parâmetros não for fixa, as mesmas combinações podem ser acessadas por caminhos diferentes. Os filtros de três itens passam a ter 6 ordens possíveis (27.500 × 6 = 165.000) e os de dois, 2 ordens (1.650 × 2 = 3.300). O total vai a 168.361 por categoria, ou 168.361 ÷ 29.211 = 5,8 vezes mais. Se apenas 6 das combinações da categoria tiverem demanda real de busca, as URLs que valem ser indexadas são 6.
URLs por categoria em cada cenário
O gráfico resume a tese do artigo: a diferença entre expor tudo e expor o que tem demanda é de ordens de grandeza. O trabalho de SEO é escolher as poucas URLs que merecem existir na busca e controlar as demais.
As técnicas disponíveis e o que cada uma faz
Cada técnica atende a um objetivo diferente. A tabela separa o que a documentação do Google afirma da recomendação prática.
| Técnica | O que faz (segundo o Google) | Quando usar (recomendação) | Risco |
|---|---|---|---|
| robots.txt disallow | Impede o rastreamento. É a opção indicada quando as facetas não precisam aparecer na Busca. Não é um mecanismo para tirar página do Google | Facetas sem demanda, ordenação e filtros em massa | O Google nunca lê noindex ou canonical de URL bloqueada; a URL pode aparecer sem descrição; regra mal escrita bloqueia o que não deveria |
| rel=canonical | Sinal forte de consolidação; pode reduzir o rastreamento no longo prazo, mas é descrito como menos eficaz que o robots.txt para isso | Variantes quase idênticas que podem continuar rastreáveis | O Google pode escolher outro canonical; a URL continua sendo rastreada |
| noindex | Remove a URL da Busca, desde que ela não esteja bloqueada no robots.txt | URLs que precisam ser rastreáveis, mas ficar fora do índice, como categoria vazia | Não poupa rastreamento, pois o Google ainda busca a página |
| nofollow interno | Menos eficaz no longo prazo; só funciona se todos os links para a URL o tiverem | Complemento a outra técnica | Um único link sem nofollow anula o efeito |
| Fragmento (#) | O Google em geral não usa fragmentos para rastrear e indexar; filtros por # não afetam rastreamento nem indexação | Filtros AJAX sem URL própria | Nada será descoberto nem indexado |
| 404 em combinação vazia | Recomendado pela documentação para combinações inexistentes ou sem resultado | Filtros sem produtos | Pode ser difícil de implementar em páginas de aplicação única |
| Sitemap | Sinal fraco de canonical | Listar só as facetas indexáveis | Conflito com canonical enfraquece o sinal |
Árvore de decisão: indexar, bloquear ou consolidar
A pergunta de partida é uma só: essa combinação de filtros tem demanda de busca própria e conteúdo que justifique uma página? Por exemplo, “tênis de corrida masculino preto” tem. Uma faixa de preço ou uma ordenação por “mais vendidos” não.
A árvore abaixo resume o caminho de decisão para cada padrão de URL facetada, com base nas documentações do Google citadas neste artigo.
Indexar, bloquear ou consolidar
Um caminho de decisão por padrão de URL
A combinação de filtros tem demanda de busca e produtos suficientes?
ex.: “tênis de corrida masculino preto” sim; faixa de preço ou ordenação, não↓
URL amigável e estável, canonical autorreferente, H1 e title próprios, texto único, link a partir da categoria e inclusão no sitemap.
A URL precisa ser rastreada?
Disallow no robots.txt para os parâmetros, ou filtros em fragmento (#).
Noindex, sem disallow.
Canonical para a versão principal, sem disallow.
Regra de ouro: um objetivo por URL. Disallow combinado com noindex ou canonical impede que o Google veja essas instruções.
Faceta sem demanda
Se as URLs facetadas não precisam aparecer na Busca, a documentação do Google indica impedir o rastreamento, com disallow no robots.txt para os parâmetros e allow para a listagem sem filtro e para as páginas de produto. Outra via é usar fragmentos (#), que não afetam rastreamento nem indexação. Canonical e nofollow podem complementar, mas são descritos como menos eficazes no longo prazo.
Na página oficial, o exemplo de robots.txt mostra o formato recomendado: bloquear os parâmetros de filtro e liberar a listagem completa, além da alternativa com fragmentos de URL.
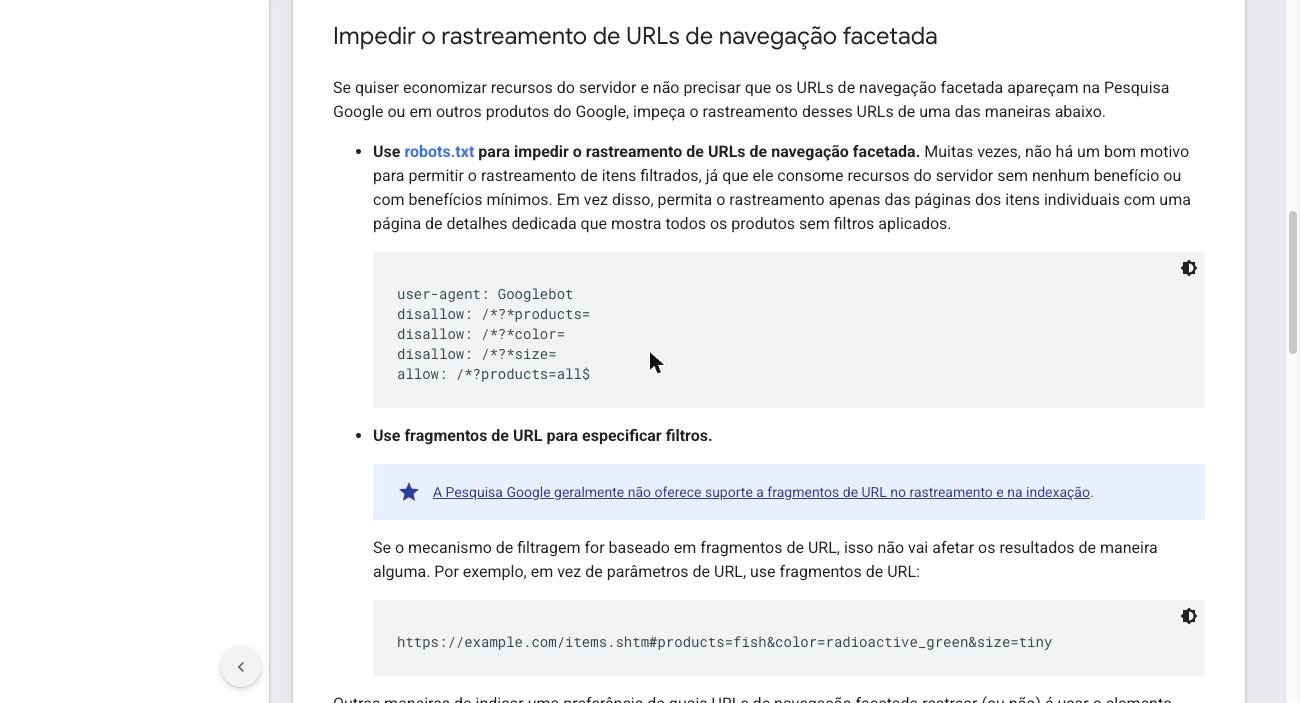
Há uma regra de ouro, que vem da documentação de noindex: escolha um objetivo por URL. Se a URL não deve ser rastreada, use disallow. Se deve ser rastreada, mas ficar fora do índice, use noindex sem disallow. Se o objetivo é consolidar sinais, use canonical sem disallow. Nunca combine disallow com noindex ou canonical esperando que funcionem.
Faceta com demanda
Mantenha a URL rastreável e indexável, seguindo as boas práticas da documentação: use “&” como separador de parâmetros, mantenha a ordem dos filtros consistente, evite repetir o mesmo filtro e retorne 404 para combinações sem resultado em vez de redirecionar para uma página de erro genérica. A página sobre estrutura de URL para e-commerce acrescenta canonical autorreferente nas páginas indexáveis, o mesmo formato de URL nos links internos, no sitemap e no canonical, e links reais com <a href>.
A faceta indexável merece uma URL amigável e estável (por exemplo, /tenis/masculino/preto), H1 e title próprios com a consulta-alvo, um texto introdutório único, breadcrumb, link interno a partir da categoria-pai e inclusão no sitemap. Só publique a faceta se houver produtos suficientes e estoque estável. O guia de SEO para página de categoria mostra como estruturar essas páginas.
Paginação, parâmetros e variantes
Na documentação sobre paginação, cada página deve ter URL própria, com canonical autorreferente. Apontar todas as páginas para a primeira contraria a orientação. O Google já não usa rel=next e rel=prev. Para parâmetros, prefira valores combinados em um parâmetro (por exemplo, ?tipo=a,b) em vez de repetir o mesmo parâmetro. Para variantes de produto com URL própria, o canonical aponta para a URL principal do produto.
Como implementar e auditar, passo a passo
- Inventário. Liste filtros, parâmetros, ordenações e paginação, e mapeie quais geram URL.
- Demanda. Cruze as facetas com pesquisa de palavras-chave e com as consultas reais do Search Console para escolher as indexáveis. O guia de Google Search Console ajuda na leitura.
- Classificação. Para cada padrão de URL, decida entre indexar, bloquear com disallow, noindex rastreável ou canonical.
- Implementação. Fixe a ordem dos parâmetros no back-end, retorne 404 em combinações vazias, use links reais para as facetas estratégicas, mantenha canonical autorreferente nas indexáveis e coloque só elas no sitemap. A configuração do arquivo é explicada em sitemap XML e robots.txt: guia básico.
- Teste. Valide o robots.txt no Search Console antes de publicar a regra.
- Auditoria de logs. No log do servidor, filtre o Googlebot (confirmando por DNS reverso) e calcule a parcela das requisições em URLs com parâmetros, antes e depois da mudança.
- Relatório de páginas. No Search Console, examine “Descobertas, no momento sem indexação”, “Página alternativa com tag canonical adequada”, “Bloqueada pelo robots.txt” e “Soft 404”. Veja também rastreada, mas não indexada: o que significa.
- Rastreador desktop. Um rastreador como o descrito em Screaming Frog para auditar SEO técnico encontra loops de filtros, canonical conflitante e parâmetros repetidos.
- Monitoramento. Acompanhe por 4 a 8 semanas. O Google indica que canonical e nofollow agem no longo prazo, e URLs bloqueadas podem demorar a sair da fila.
Erros comuns em navegação facetada
Os erros abaixo aparecem em auditorias de lojas de todos os portes. Eles estão agrupados por natureza, com o motivo, o efeito no resultado e a correção.
Erros de controle de rastreamento e indexação
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Disallow e noindex na mesma URL | O Google não rastreia a página e nunca lê o noindex; a URL pode seguir listada sem descrição | Remover o disallow, deixar a URL ser rastreada até sair do índice e só depois decidir |
| Usar noindex para poupar rastreamento | O Google ainda busca a página antes de descartá-la; não há ganho de orçamento | Usar disallow nas URLs que não devem ser rastreadas |
| Usar disallow para “desindexar” | O robots.txt não tira página do Google; a URL aparece sem descrição se houver links | Usar noindex rastreável |
| Disallow e canonical juntos | O canonical nunca é lido; os sinais não se consolidam | Escolher um objetivo por URL |
| Sitemap com URLs que o canonical contradiz | Há sinais conflitantes; o Google escolhe por conta própria | Listar só URLs canônicas e indexáveis |
Erros de estrutura de URL
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Ordem de parâmetros variável | A, B e C geram várias URLs equivalentes; no exemplo, 5,8 vezes mais URLs | Fixar a ordem por regra no back-end |
| Parâmetro repetido (?cor=a&cor=b) | URLs extras, difíceis de interpretar e de controlar | Combinar os valores (?cor=a,b) ou usar caminho |
| Redirecionar combinação vazia para página genérica | Gera soft 404 e desperdício de rastreamento | Retornar 404 na própria URL |
| Filtros só em JavaScript, sem link real | Facetas estratégicas não são descobertas | Usar links com href para as facetas indexáveis |
| Canonical de todas as páginas paginadas para a primeira | Produtos das páginas seguintes podem não ser descobertos | Canonical autorreferente por página |
Erros de estratégia de conteúdo
| Erro | Por que acontece e qual o efeito | Correção |
|---|---|---|
| Indexar faceta sem conteúdo próprio | Páginas finas disputam a mesma intenção da categoria; os sinais se dividem | H1, title e texto únicos, ou não indexar |
| Indexar tudo sem checar demanda | Explosão de URLs com pouca ou nenhuma busca | Cruzar com palavras-chave e Search Console |
| Bloquear tudo sem checar demanda | Perde-se tráfego de cauda longa que a faceta capturaria | Mapear as combinações com demanda e mantê-las indexáveis |
Checklist de navegação facetada
- Inventário de filtros, parâmetros e ordenações feito.
- Facetas com demanda de busca identificadas e listadas.
- Cada padrão de URL com um único objetivo: indexar, bloquear, noindex ou canonical.
- Ordem de parâmetros fixa no back-end.
- 404 para combinações sem resultado.
- Canonical autorreferente nas facetas indexáveis.
- Sitemap só com URLs indexáveis.
- Robots.txt testado antes de publicar.
- Logs do Googlebot analisados antes e depois.
- Revisão a cada coleção ou trimestre.
Perguntas frequentes
Posso usar só canonical e liberar o rastreamento das facetas?
A documentação do Google descreve o canonical como menos eficaz que o robots.txt para controlar rastreamento no longo prazo. Ele serve para consolidar sinais, não para impedir que o Google busque a URL.
Fragmento (#) ajuda no SEO de filtros?
Para filtros sem demanda, evita impacto no rastreamento, porque o Google em geral não usa fragmentos. Em contrapartida, esses filtros nunca serão indexados nem descobertos.
Preciso me preocupar com orçamento de rastreamento?
Segundo o Google, principalmente em sites muito grandes ou com muitas URLs descobertas e sem indexação. Lojas menores costumam resolver com sitemap atualizado e atenção ao relatório de indexação, mas a duplicação ainda importa para consolidar sinais.
Faceta com poucos produtos deve ser indexada?
Se tem demanda e estoque estável, sim, com conteúdo próprio. A documentação orienta usar noindex ou 404 em categorias vazias.
Como fica a paginação nas categorias com filtro?
Cada página deve ter URL própria e canonical autorreferente, com links reais para a página seguinte. O rel=next e o rel=prev não são mais usados pelo Google.
Posso editar o robots.txt na minha plataforma de e-commerce?
Depende da plataforma. Em algumas ele é editável no painel; em outras, só em parte. Confirme na documentação da sua plataforma antes de planejar o bloqueio de parâmetros.