
Durante meses, quem usava a Cloudflare para barrar o treino de modelos de IA enfrentava um dilema desconfortável. Bloquear o rastreamento de treinamento significava, na prática, arriscar a própria visibilidade na busca. Googlebot, Applebot e Bingbot fazem as duas coisas ao mesmo tempo, rastreiam para a busca e alimentam modelos, e não havia como separar uma função da outra sem pagar um preço alto.
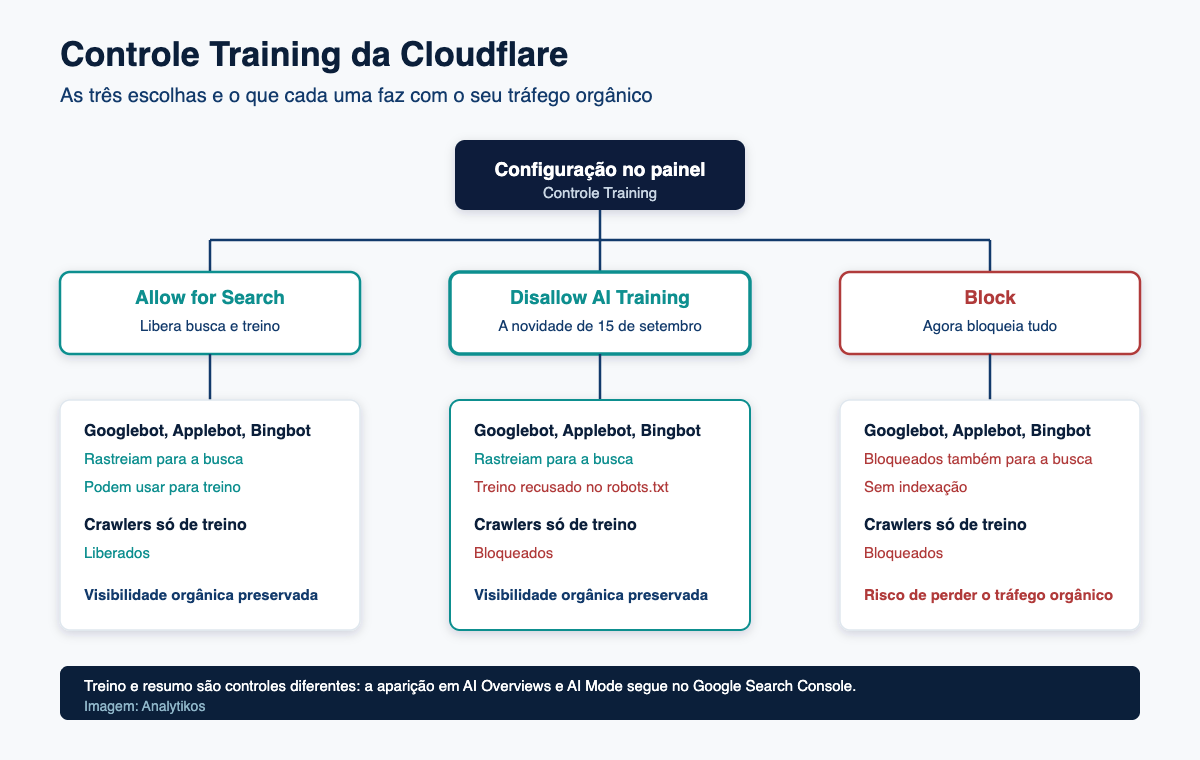
No dia 15 de setembro, a Cloudflare ligou a chave que desata esse nó. A nova configuração Disallow AI Training publica no seu robots.txt a preferência de não treinamento e, ao mesmo tempo, mantém os rastreadores de busca liberados para indexar o site, como a própria empresa detalhou no seu blog oficial. Quem já bloqueava treino de IA será migrado automaticamente para a nova opção.
A mudança traz uma contrapartida importante e pouco divulgada. A opção Block, que antes poupava esses três rastreadores justamente para não derrubar a visibilidade orgânica, agora bloqueia todos eles de verdade, inclusive para a busca. Se alguém do time marcar a caixa errada achando que está apenas protegendo conteúdo, o site sai do índice. Vale entender os detalhes antes de mexer.
O que mudou de fato em 15 de setembro
O Disallow AI Training é uma opção nova dentro do controle Training da Cloudflare, que faz parte de um trio de controles ao lado de Search e Agent. Quando está ativa, os rastreadores de uso misto, aqueles que servem à busca e ao treinamento, continuam liberados para a busca, desde que a Cloudflare os classifique como Accountable. Os demais rastreadores de treino seguem bloqueados.
O plano anunciado em julho era outro. Naquela época, a previsão era que sites que bloqueassem treino de IA passariam a bloquear também os três rastreadores de busca a partir de 15 de setembro, justamente por serem de uso misto. A empresa recuou desse caminho e criou a opção intermediária, segundo a cobertura do Search Engine Journal.
Na migração, as seleções existentes de Block ou Block on pages with ads dentro do controle Training passam para Disallow AI Training. Sites que usavam qualquer uma das opções de bloqueio no antigo botão Block AI Bots recebem a combinação Allow for Search, Disallow AI Training e Block on pages with ads. O antigo Block AI Bots e o recurso Managed Robots.txt entram em processo de descontinuação.
A maioria dos clientes não precisa mudar nada.
Cloudflare, sobre a migração automática das configurações
Quem entra na lista Accountable e por quê
Os rastreadores de uso misto só mantêm acesso à busca se a Cloudflare os rotular como Accountable, uma designação criada depois de conversas com operadores de rastreadores iniciadas em julho. Para se qualificar, o operador precisa cumprir, ou se comprometer formalmente a cumprir, quatro requisitos.
| Requisito | O que significa na prática |
|---|---|
| Opt-out de treino | Oferecer uma forma de recusar o treino de IA via robots.txt ou padrão equivalente |
| Opt-out de resumos | Permitir recusar o uso do conteúdo em resumos gerados por IA, hoje direto com o operador |
| Transparência por URL | Mostrar quais páginas foram disponibilizadas para treino e como o conteúdo apareceu na busca |
| Neutralidade na busca | Garantir que recusar o treino não prejudica o desempenho na busca tradicional |
Apple, Google e Microsoft atendem a esses critérios, cada uma com recursos já disponíveis e prazos assumidos para o restante. Amazon, Anthropic, Meta e OpenAI também aparecem como Accountable, mas por um motivo diferente: elas operam rastreadores separados para busca e para treino. Os rastreadores de treino dessas empresas continuam bloqueados sob a nova configuração.
Como a regra se traduz em Google, Apple e Bing
Cada plataforma implementa o opt-out de um jeito, e a cobertura vale a pena ser conferida linha a linha antes de qualquer decisão.
| Plataforma | Mecanismo acionado | Afeta a busca? |
|---|---|---|
| Regra Disallow para o token Google-Extended no robots.txt | Não. A documentação do Google afirma que o Google-Extended não afeta inclusão nem ranqueamento na Busca | |
| Apple | Regra Disallow para Applebot-Extended | Não. O Applebot-Extended não rastreia páginas e não entra no ranqueamento |
| Bing | Ainda sem suporte via robots.txt. O opt-out atual é a meta tag NOARCHIVE | NOARCHIVE também tira os links do Chat e do Copilot |
O detalhe do Bing merece atenção. Escolher Disallow AI Training na Cloudflare ainda não envia à Microsoft uma preferência de não treinamento pelo robots.txt, porque o suporte está em construção. A empresa mira o início de 2027 para entregar esse recurso. Até lá, o caminho continua sendo a NOARCHIVE, que tem um efeito colateral relevante para quem quer aparecer no Copilot.
O erro conceitual que custa tráfego: treino não é resumo
Esse é o ponto que mais gera confusão em reuniões de SEO, e ele não é novo. Recusar o treino de modelos e recusar a exibição do seu conteúdo em respostas geradas são duas decisões distintas, com controles distintos.
No Google, o Google-Extended cuida do treino do Gemini. Já a aparição do site nas AI Overviews, no AI Mode e nos recursos generativos do Discover é controlada por uma configuração separada dentro do Search Console, e a página de ajuda do Google deixa claro que essa configuração não interfere no treino. São chaves diferentes, em painéis diferentes. Quem trata as duas como sinônimo acaba desligando visibilidade sem querer, ou acha que protegeu conteúdo quando não protegeu.
Esse tipo de confusão já apareceu em outros formatos. Vale lembrar do caso do llms.txt, que não bloqueia crawler algum apesar de muita gente acreditar que sim, e do Gemini Notebook, que passa por cima do robots.txt em determinados cenários. A lição se repete: o nome do arquivo ou da caixinha não determina o comportamento real do rastreador.
O que fazer no seu site ainda esta semana
- Confira em qual configuração você caiu. A migração é automática, mas o resultado depende de como estava o setup anterior. Abra o painel e confirme se o controle Training está em Disallow AI Training e não em Block.
- Leia o robots.txt depois da mudança. A preferência é publicada nesse arquivo, então ele é a prova de que a configuração fez o que prometeu. Procure a regra de Disallow para Google-Extended e Applebot-Extended.
- Separe as duas decisões no papel. Registre, para o time e para o cliente, qual é a política de treino e qual é a política de aparição em respostas de IA. São conversas comerciais diferentes.
- Reveja a NOARCHIVE se o Copilot importa. Se o tráfego vindo do Copilot tem valor no seu funil, pesar o opt-out de treino no Bing contra a perda desses links deixou de ser detalhe técnico.
- Documente a data. Qualquer oscilação de rastreamento ou indexação a partir de 15 de setembro precisa ser cruzada com essa mudança antes de virar diagnóstico de algoritmo.
O que vem pela frente
A Cloudflare informa que o Google deve lançar ferramentas de transparência por URL para o Google-Extended nas próximas semanas, e que a Apple trabalha na sua versão para o ano que vem. O suporte da Microsoft à preferência de não treinamento no robots.txt está mirado para o início de 2027.
O próximo alvo declarado da empresa são os resumos de IA. A meta é oferecer um único controle capaz de definir quanto do conteúdo entra em resumos, no lugar do ajuste operador por operador que existe hoje. Se isso funcionar, a negociação entre publishers e plataformas deixa de ser bilateral e passa a ter um ponto único de controle, o que muda bastante o jogo para quem já trata a visibilidade em IA como produto e para quem acompanha os testes do Google de remunerar sites por conteúdo usado em IA.
Por ora, a leitura prática é simples. Pela primeira vez existe uma opção que não obriga o site a escolher entre proteger conteúdo e continuar sendo encontrado. Aproveitar essa opção exige apenas que ninguém clique no botão errado.
Perguntas frequentes
O Disallow AI Training tira meu site do Google?
Não. Essa é justamente a diferença da nova configuração. Ela publica a preferência de não treinamento no robots.txt e mantém Googlebot, Applebot e Bingbot liberados para rastrear para a busca. Quem tira o site do Google é a opção Block, que passou a valer também para esses rastreadores.
Recusar o treino de IA prejudica meu ranqueamento?
Segundo a documentação do Google, não. A empresa afirma que o token Google-Extended não afeta a inclusão do site na Busca nem o seu ranqueamento. A Apple faz afirmação equivalente sobre o Applebot-Extended, que sequer rastreia páginas.
Essa configuração impede meu conteúdo de aparecer nas AI Overviews?
Não. Treino e exibição em respostas geradas são controles separados. A aparição nas AI Overviews, no AI Mode e nos recursos generativos do Discover é definida em uma configuração própria dentro do Google Search Console.
E o Bing, funciona igual?
Ainda não. A Microsoft precisa implementar o suporte à preferência de não treinamento via robots.txt, previsto para o início de 2027. Até lá, o opt-out de treino no Bing é a meta tag NOARCHIVE, que também remove os links do Chat e do Copilot.
Preciso mudar alguma coisa manualmente?
Na maioria dos casos não, porque a migração é automática. Ainda assim vale abrir o painel e confirmar em qual opção o seu domínio ficou, especialmente se o time usava o antigo botão Block AI Bots, e conferir o robots.txt resultante.