
Toda vez que um laboratório lança um modelo novo, vem junto um gráfico de barras com o nome de algum teste conhecido e a barra do concorrente um pouco mais baixa. O gráfico circula, vira post, vira decisão de compra. E quase nunca alguém pergunta o que aquele teste mede e se ele ainda serve para medir.
Essa pergunta virou um negócio de 40 milhões de dólares. A Vals, startup fundada em 2024, levantou uma série A liderada pela Andreessen Horowitz para tentar ocupar um lugar que hoje não existe direito: o de avaliador independente de modelos de IA. A história foi contada pelo TechCrunch e confirmada no anúncio oficial da a16z.
Se você escolhe modelo para rodar operação de marketing, atendimento ou conteúdo, essa discussão não é de laboratório. É a diferença entre trocar de fornecedor por causa de um número real e trocar por causa de um material de divulgação.
O problema: prova pública é prova decorável
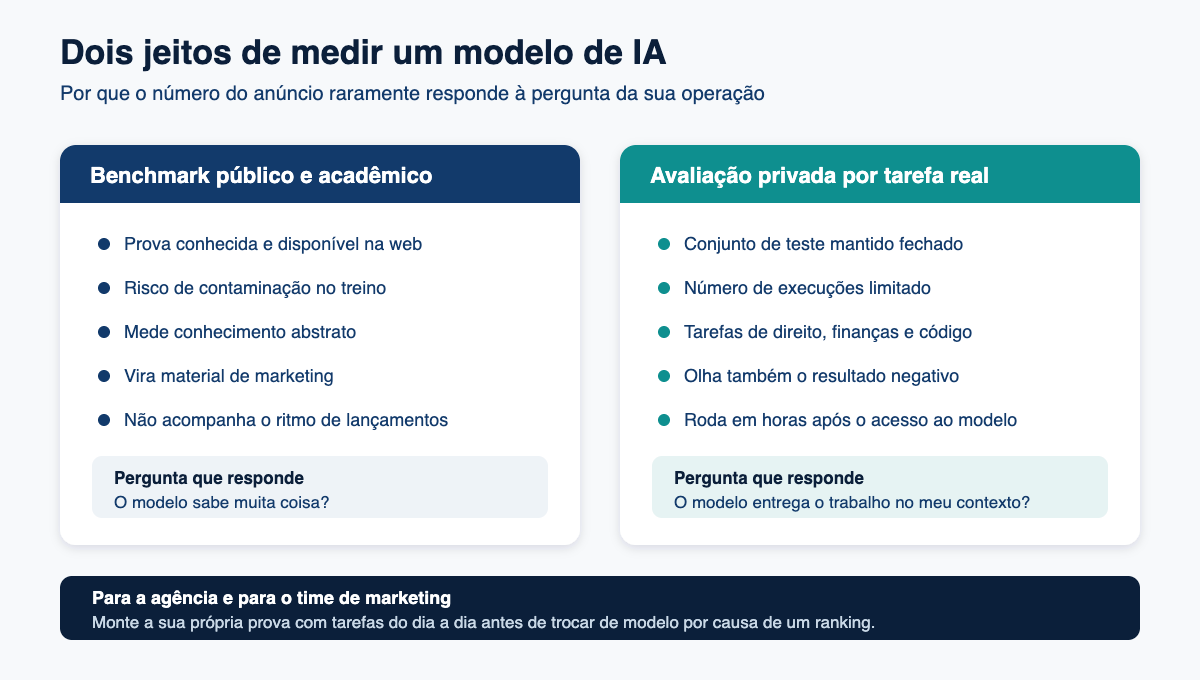
A maior parte dos benchmarks tradicionais é aberta. O conjunto de perguntas está na internet, o gabarito também. Quando o material de teste faz parte do corpus de treino, o resultado deixa de medir capacidade e passa a medir memorização. A MIT Technology Review tratou o tema de forma direta ao afirmar que os benchmarks de IA estão quebrados.
Some a isso o descompasso de ritmo. Boa parte das provas em uso foi desenhada para uma geração anterior de modelos. Rayan Krishnan, cofundador da Vals, resume o diagnóstico que originou a empresa.
Estávamos vendo muitos modelos novos e muito capazes chegarem ao mercado rapidamente, e os benchmarks acadêmicos não estavam acompanhando esse avanço da fronteira.
Rayan Krishnan, cofundador da Vals, ao TechCrunch
O que a Vals faz de diferente
Três escolhas definem o método. A primeira é não divulgar o material de teste, o que reduz a chance de contaminação no treino. A segunda é limitar o número de execuções por modelo, o que dificulta a otimização por tentativa e erro. A terceira é medir tarefa de domínio, não conhecimento geral: direito, finanças e programação, em vez de simulado de prova de admissão.
A pergunta que orienta o desenho é outra. Em vez de “o modelo sabe o suficiente”, a Vals pergunta se ele entrega um produto com a mesma qualidade que um humano entregaria naquele domínio. E diz olhar também para o resultado negativo, ou seja, o que acontece de errado quando o modelo opera solto.
O escopo tem crescido para áreas incômodas: autoaperfeiçoamento recursivo, saúde mental, cibersegurança, biossegurança e até aplicação das convenções de guerra. Não é avaliação de produtividade, é avaliação de risco.
O modelo de negócio incomoda e explica muita coisa
Quem paga pela avaliação é a própria empresa que fabrica o modelo. Krishnan compara com o estudante que paga ao College Board para fazer o SAT. A analogia é honesta, mas não resolve sozinha a tensão: um avaliador remunerado pelo avaliado precisa de salvaguardas visíveis para sustentar a reputação de neutro.
Essa tensão não é exclusiva da Vals. Ela apareceu também quando a Anthropic contratou a Accenture como avaliador embarcado. O mercado está inventando a figura do auditor de IA em tempo real, e ainda não definiu como ela se paga sem capturar o julgamento.
| Critério | Benchmark público | Avaliação privada por tarefa |
|---|---|---|
| Material de teste | Disponível na web | Mantido fechado |
| Risco de contaminação | Alto | Reduzido |
| O que mede | Conhecimento e raciocínio abstrato | Execução de tarefa de domínio |
| Uso típico | Comunicação e comparação de mercado | Decisão de adoção e governança |
| Quem paga | Instituição acadêmica ou comunidade | O fabricante do modelo |
Por que isso chega ao time de marketing
Agência e time interno trocam de modelo com frequência crescente, e a justificativa quase sempre vem de um ranking público. O problema é que nenhum desses rankings testa a sua tarefa: reescrever descrição de produto no tom da marca, classificar ticket de atendimento em português do Brasil, montar briefing a partir de planilha bagunçada.
Além disso, o custo entrou na conta de vez. Já mostramos que o preço do token caiu mil vezes e a fatura subiu, porque o consumo cresceu mais rápido que o desconto. Escolher modelo pelo topo do ranking, sem medir custo por tarefa concluída, é uma decisão cara disfarçada de decisão técnica.
Como montar a sua própria avaliação
Junte de 30 a 50 casos reais
Pegue entregas que já saíram e foram aprovadas pelo cliente. Esse é o seu gabarito. Não precisa de mil exemplos: precisa de exemplos representativos da variação real do trabalho, incluindo os casos chatos.
Mantenha o conjunto fora dos prompts do dia a dia
Se os mesmos casos circulam nas conversas de produção, eles deixam de ser teste. Guarde em repositório separado e use apenas nas rodadas de avaliação.
Defina critérios antes de ver o resultado
Escreva a régua primeiro: precisão factual, aderência ao tom, formato, tempo e custo por tarefa. Sem régua prévia, a avaliação vira torcida pelo modelo que a equipe já prefere.
Meça também o que dá errado
Liste os erros inaceitáveis para o seu contexto: inventar dado de cliente, citar fonte que não existe, vazar informação entre contas. Um modelo com média melhor e uma falha grave é pior que um modelo mediano e previsível. O tema conversa com o que discutimos sobre código de conduta para modelos de IA.
O sinal maior por trás da rodada
Krishnan aposta que avaliação vai deixar de ser conteúdo de blog técnico e virar item de relatório para investidor, à medida que empresas de IA abram capital. Faz sentido: quando o modelo é o ativo, a métrica do ativo precisa ser auditável por alguém de fora.
Esse movimento se encaixa em uma tendência mais ampla de medir a IA com régua própria, que vimos quando a Anthropic passou a publicar métricas do próprio ritmo de desenvolvimento e quando modelou cenários econômicos da IA até 2030. A indústria descobriu que precisa de números que não sejam autoelogio.
Para quem opera, a conclusão prática é anticlimática e útil: nenhum avaliador externo, por melhor que seja, vai testar exatamente o seu trabalho. A avaliação independente melhora o mercado. A sua avaliação interna é a que decide o seu contrato.
Perguntas frequentes
O que é um benchmark de IA?
É um conjunto padronizado de tarefas usado para comparar o desempenho de modelos de linguagem. O resultado costuma ser divulgado como pontuação e serve tanto para pesquisa quanto para comunicação de mercado.
Por que os benchmarks públicos são criticados?
Porque o material de teste está disponível na internet e pode acabar no corpus de treino do modelo. Quando isso ocorre, a pontuação mede memorização e não capacidade real de resolver tarefas novas.
O que a Vals faz de diferente dos benchmarks tradicionais?
Mantém o conjunto de teste fechado, limita o número de execuções por modelo e avalia tarefas de domínios como direito, finanças e programação, olhando também para os resultados negativos.
Faz sentido o fabricante do modelo pagar pela própria avaliação?
É o modelo adotado pela Vals, comparado por seus fundadores ao estudante que paga para prestar um exame padronizado. Funciona enquanto houver salvaguardas claras de independência, e esse é o ponto que o mercado ainda está definindo.
Como escolher um modelo de IA para a minha operação?
Monte um conjunto de 30 a 50 casos reais já aprovados, mantenha esse conjunto fora do uso diário, defina critérios antes de rodar o teste e meça também o custo por tarefa concluída e os erros inaceitáveis.