
Um DELETE no log do servidor costuma disparar o alarme antes da pergunta. No meio das visitas do Googlebot aparecem métodos que ninguém esperava, como PUT, DELETE e OPTIONS, e a primeira reação quase sempre é a mesma: desconfiar de ataque ou de invasão. Na maioria dos casos, não é nada disso.
A explicação partiu do próprio Google. Gary Illyes, analista da equipe de Search Relations, confirmou que os rastreadores da empresa enviam bem mais do que o tradicional GET e apontou o responsável: o JavaScript da sua própria página, executado durante a renderização. Para times de SEO técnico, isso encerra uma dúvida antiga e escancara o quanto a renderização pesa no rastreamento.
Este texto traduz o assunto em rotina de trabalho: por que cada método aparece, o que muda na leitura dos seus logs e como separar comportamento esperado do que merece investigação de verdade.
O que o Google confirmou sobre os métodos de requisição
A dúvida partiu de profissionais que notaram, nos registros de acesso, chamadas atípicas atribuídas ao Google. Ao responder, Illyes foi direto: os crawlers da empresa não se limitam a GET e POST. Eles também disparam HEAD, OPTIONS, PUT, PATCH e DELETE em determinadas situações. A confirmação, feita pelo próprio Gary Illyes em publicação no LinkedIn, foi replicada pela imprensa especializada, como noticiou o Search Engine Roundtable.
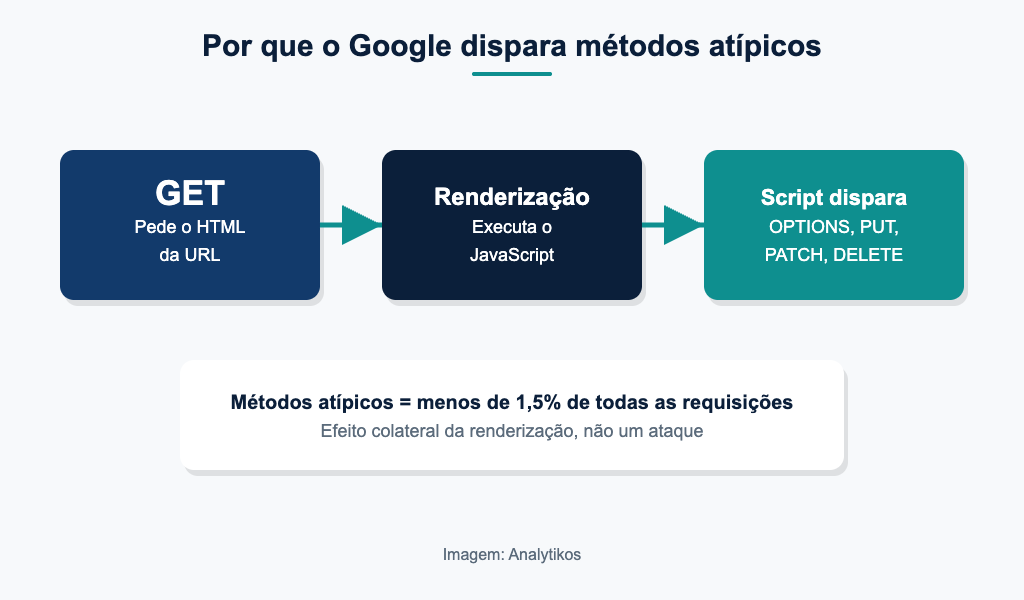
O ponto mais importante é o volume. De acordo com Illyes, esses métodos menos comuns representam menos de 1,5% do total de requisições somando todos os crawlers do Google. Ou seja, a esmagadora maioria do rastreamento continua sendo feita com GET, o método que simplesmente pede o conteúdo de uma URL. Os demais são exceção, e não a regra.
Esses métodos atípicos representam menos de 1,5% de todas as requisições dos crawlers do Google, e costumam ser disparados por alguma bagunça de JavaScript.
Gary Illyes, Google
Por que o JavaScript dispara PUT, DELETE e OPTIONS
A explicação está no jeito como o Google renderiza páginas. Para entender o que um site realmente mostra ao usuário, o buscador não lê apenas o HTML inicial: ele executa o JavaScript da página, como um navegador faria. Durante essa execução, scripts podem disparar chamadas de rede por conta própria, e nem sempre com o método GET.
Pense em uma página que carrega um mapa interativo, um chat, um carrossel de produtos ou um formulário dinâmico. Esses componentes costumam conversar com APIs em segundo plano, usando métodos como OPTIONS (parte do mecanismo de verificação entre domínios, o CORS), PUT ou PATCH (para atualizar dados) e até DELETE. Quando o Google renderiza a página, ele acaba executando esses scripts, e as chamadas viajam junto. Não há intenção de alterar nada no seu servidor, e sim um efeito colateral da renderização. O funcionamento do rastreamento em 2026 foi detalhado pelo Search Engine Land, que ajuda a contextualizar por que a etapa de renderização ficou tão central.
O que isso muda na leitura dos seus logs
A análise de logs continua sendo uma das ferramentas mais honestas de SEO técnico, porque mostra o que o Google faz de verdade, e não o que achamos que ele faz. A novidade é que ver um DELETE ou um OPTIONS vindo de um IP legítimo do Googlebot deixou de ser motivo automático de alarme. Antes de bloquear qualquer coisa, vale entender a origem.
A tabela abaixo resume os principais métodos, o que costumam significar e a ação recomendada ao encontrá-los nos registros.
| Método | Sinal típico | Ação recomendada |
|---|---|---|
| GET | Rastreamento normal de conteúdo | Nenhuma, é o esperado |
| OPTIONS | Verificação de permissão entre domínios (CORS) | Não bloquear, faz parte da renderização |
| PUT / PATCH / DELETE | Efeito colateral de scripts na renderização | Confirmar o IP como Googlebot antes de agir |
| HEAD | Checagem de cabeçalhos sem baixar o corpo | Comportamento legítimo, manter |
O primeiro passo prático é sempre validar se a requisição veio mesmo do Google, checando o IP por DNS reverso. Ataques que se passam pelo Googlebot são comuns, e o método usado, sozinho, não prova nada. Depois de confirmada a origem, a orientação é clara: não há necessidade de criar regras agressivas para barrar esses métodos só por serem incomuns.
Como isso se conecta à estratégia de rastreamento
Há uma leitura estratégica por trás da curiosidade técnica. Se a renderização dispara chamadas extras, ela consome recursos, e recursos de rastreamento não são infinitos. Sites muito dependentes de JavaScript tendem a exigir mais trabalho do buscador para serem compreendidos, o que reforça a importância de acompanhar o orçamento de rastreamento e de manter uma arquitetura enxuta.
Vale também lembrar que rastreamento é um tema cada vez mais disputado. Enquanto o Google refina como lê as páginas, cresce o debate sobre outros robôs, especialmente os de IA. Já mostramos como lidar com o rastreador do Gemini Notebook que ignora o robots.txt e como enxergar melhor a origem do tráfego com o Platform Properties no Search Console.
O ponto de fundo é que a camada de rastreamento virou terreno de decisão, não de infraestrutura. Em poucos meses a Cloudflare passou a separar treino de IA e busca e o próprio Google endureceu o bloqueio a scrapers, tirando dados de ferramentas de rank tracking. Saber qual robô fez o quê, e com qual método, deixou de ser curiosidade e virou pré-requisito para tomar qualquer decisão de bloqueio.
No fim, a mensagem para o time técnico é tranquilizadora: aquele DELETE misterioso no log provavelmente é o próprio Google executando o seu JavaScript, e não um invasor. O trabalho continua o de sempre, garantir que o conteúdo essencial esteja acessível de forma simples, sem depender demais de scripts para existir.
Perguntas frequentes
O Googlebot pode apagar dados do meu site com o método DELETE?
Não. As requisições são um efeito colateral da execução do JavaScript da própria página durante a renderização. O Google não tem intenção nem permissão de alterar dados no seu servidor, e seu backend só executa a ação se estiver mal configurado.
Devo bloquear métodos como PUT e OPTIONS vindos do Google?
Não como regra. Illyes explicou que esses métodos são esperados e representam menos de 1,5% das requisições. Bloqueios agressivos podem atrapalhar a renderização. Confirme sempre se o IP é realmente do Googlebot antes de qualquer ação.
Como sei se a requisição veio mesmo do Google?
Faça a verificação por DNS reverso do IP. O Google publica orientações para validar seus crawlers. Muitos acessos maliciosos se passam pelo Googlebot, então o nome no log não basta.
Isso afeta meu orçamento de rastreamento?
Indiretamente. Páginas muito dependentes de JavaScript exigem mais renderização, o que consome recursos. Manter o conteúdo essencial acessível sem depender de scripts ajuda o buscador a trabalhar de forma mais eficiente.
Qual a diferença entre bloquear um método HTTP e bloquear um user agent no robots.txt?
São camadas distintas. O robots.txt pede que um rastreador não busque determinadas URLs e depende da cooperação dele. Restringir métodos HTTP é uma regra de servidor que vale para qualquer origem. Limitar OPTIONS ou PATCH em caminhos que servem a aplicação JavaScript atrapalha a renderização, então esse tipo de restrição deve ficar em endpoints que você mantém fora do índice.